Comment choisir son ESN Data & IA pour moderniser sa plateforme data et déployer du RAG souverain ?

En 2026, moderniser la plateforme data est devenu un chantier qu’on ne peut pas repousser, c’est même le prérequis à tout projet d’IA industrialisé. Mais face à la multiplication des ESN qui affichent une expertise Data & IA, comment un DSI ou un CDO fait-il le bon choix ? Voici les critères qui comptent vraiment.

En résumé
  • Un ESN généraliste traite la data comme une activité parmi d’autres, un pure player Data & IA y consacre 100 % de ses ressources. Ce n’est pas le même niveau d’expertise en production.
  • Moderniser sa plateforme data et déployer du RAG sont deux projets indissociables car un RAG fiable en production exige des données propres, gouvernées et tracées à la source.
  • L’IA souveraine, c’est-à-dire déployer des LLMs sans exposer vos données à des clouds étrangers, est devenue un critère de sélection décisif avec l’AI Act pour les DSI français.
  • L’agrément CIR de votre ESN peut réduire le coût net de votre projet Data & IA de 30 %, peu d’ESN en disposent dans ce domaine.
  • 6 critères permettent de sélectionner et départager les ESN Data IA : spécialisation, delivery en production, DataOps/LLMOps, souveraineté, CIR et couverture nationale.

Pourquoi la modernisation de la plateforme data est devenue urgente

Pendant des années, les DSI ont pu différer la refonte de leur patrimoine data. Les entrepôts legacy fonctionnaient, certes pas parfaitement et de manière coûteuse, mais ils fonctionnaient. Mais ce temps est révolu.

À lire sur ce sujet : Modernisation de la BI et du SI Data : réduire la dette de la plateforme décisionnelle pour alimenter l’IA

Trois forces convergentes ont rendu la modernisation non-négociable en 2026. D’abord, l’IA générative exige des données propres : déployer un RAG ou des agents IA sur une plateforme mal gouvernée produit des hallucinations, des fuites de données et des résultats ingouvernables en production. Ensuite, l’AI Act impose une traçabilité complète des données utilisées pour alimenter les modèles IA, ce que les architectures legacy ne savent pas faire nativement. Enfin, les coûts de la dette technique data sont de plus en plus lourds, en termes de maintenance et d’évolutions mais aussi en termes de retards accumulés face à vos concurrents. Reste à trouver le bon partenaire.

Le constat terrain de Smartpoint

Les entreprises qui réussissent à industrialiser leurs usages IA ne sont pas celles qui ont les meilleurs modèles. Ce sont celles dont la DSI a structuré, certifié et piloté leurs données comme des actifs critiques du SI, avant même de commencer à parler de LLM.

Estimated reading time: 0 minute

ESN généraliste ou pure player Data & IA ?

La première différence est structurelle. Une ESN généraliste couvre une dizaine de domaines de compétences entre développement applicatif, infrastructure et production, ERP, cybersécurité et quelque part dans l’offre « Data & IA ». En réalité, les profils Data y sont souvent moins seniors, la veille technologique est moins systématique et les retours d’expérience en production IA moins capitalisés.

Un pure player Data & IA consacre 100 % de ses ressources, de sa R&D et de ses recrutements à ce seul domaine. Ses architectes ont travaillé sur des dizaines de projets de modernisation data. Ses ingénieurs LLMOps ont opéré des RAG en production. Sa veille technologique porte sur les plateformes, frameworks et standards qui structurent les stacks data & IA : Databricks, dbt, Iceberg, Mistral, LangChain… pas sur des sujets généraux.

Signal d’alarme

Si l’ESN que vous évaluez ne peut pas nommer précisément sa stack DataOps (orchestrateur, framework de tests, outil d’observabilité data), ni expliquer la différence opérationnelle entre MLOps et LLMOps, c’est que la pratique data n’est pas son cœur de métier, quelle que soit sa taille.

Les 6 critères pour choisir son ESN Data & IA à Paris et en France

01. Spécialisation réelle, pas un label marketing

Demandez le ratio de consultants data sur l’effectif total, les certifications techniques récurrentes, le nombre de projets data en production livrés ces 24 derniers mois ainsi que des références clients avec les coordonnées pour vérifier. Une spécialisation sérieuse se mesure, elle ne se déclare pas.

02. Capacité à livrer en production, pas juste des POC

La majorité des projets IA échouent entre le POC et la mise en production. Demandez des références spécifiques de projets industrialisés : pipeline data en CI/CD, RAG opéré avec monitoring, modèle ML supervisé sur plusieurs mois. Si l’ESN ne peut citer que des démonstrateurs, passez votre chemin.

03. Maîtrise du DataOps, MLOps et LLMOps

Ces trois pratiques sont essentielles pour concevoir et opérer un SI data industrialisé. DataOps pour des pipelines fiables et observables, MLOps pour les modèles classiques, LLMOps pour les LLMs et les systèmes RAG. Une ESN qui ne maîtrise que l’un des trois ne peut pas vous garantir une plateforme Data performante, ni une IA stable en production.

04. Approche souveraineté & conformité AI Act

Est-elle en capacités de déployer vos LLMs on-premise ou dans votre cloud privé ? Intègre-t-elle la conformité RGPD et AI Act dès la conception des architectures ? La souveraineté des données est un prérequis pour les DSI de grands comptes et les entreprises réglementées.

05. Agrément Crédit Impôt Recherche (CIR)

Rares sont les ESN françaises à détenir l’agrément CIR dans le domaine Data & IA. Cet agrément peut vous faire bénéficier d’un crédit d’impôt de 30 % sur les dépenses R&D éligibles comme les architectures innovantes, LLMs, RAG, agents IA. Un levier financier trop souvent ignoré.

06. Couverture nationale et modes d’intervention flexibles

Basée à Paris ou non, l’ESN doit pouvoir intervenir sur l’ensemble du territoire français sans compromis sur la qualité des livrables. Vérifiez les modèles d’engagement disponibles : régie, centre de services, engagement capacitaire, nearshore mais aussi les certifications comme ISO 27001 et 27701.

Modernisation de la plateforme data et RAG, pourquoi est-ce indissociable ?

L’une des erreurs les plus fréquentes est de vouloir déployer du RAG sans avoir préalablement modernisé les fondations data. Le résultat est inexorablement le même avec des hallucinations non détectables, des réponses non traçables et l’impossibilité de contrôler la qualité des sources.

Le RAG fonctionne en allant chercher des documents pertinents dans une base de connaissances pour les injecter dans le contexte d’un LLM. La qualité de ses réponses dépend donc directement de la qualité, de la fraîcheur et de la structuration des données sources. Si vos données sont mal gouvernées, non versionnées, sans lignage et sans contrats de données, votre RAG sera donc aussi fiable que vos données, c’est-à-dire peu.

Les étapes vers un RAG en production
Modernisation
de la plateforme data
→
Automatisation
des pipelines & DataOps
→
Gouvernance &
qualité des données
→
Vectorisation
& indexation
→
RAG supervisé
avec LLMOps
→
Agents IA
métier

C’est pourquoi choisir une ESN capable de couvrir l’ensemble de cette trajectoire, de l’architecture de la plateforme jusqu’à l’opération du RAG en production, vous permet de sécuriser votre SI Data dans la durée ; alors que de prendre des prestataires spécialisés sur chaque brique ou une ESN généraliste rend votre projet bien plus risqué.

IA souveraine ? Le critère que les DSI ne peuvent plus ignorer

L’IA souveraine désigne la capacité à déployer et opérer des modèles d’IA (LLMs, RAG, agents) dans un environnement entièrement maîtrisé, c’est à dire votre cloud privé, votre datacenter ou un cloud européen certifié, sans transfert de données vers des infrastructures étrangères.

À lire sur le sujet : Plateforme IA souveraine, opérer un RAG en production en toute confiance

Pourquoi c’est devenu urgent

Deux facteurs convergents ont mis l’IA Souveraine dans les priorités des DSI. Le premier est réglementaire avec l’AI Act, le RGPD et les exigences sectorielles (santé, finance, défense) qui imposent une traçabilité et une localisation des données incompatibles avec un envoi systématique vers des API cloud américaines. Le second est plus stratégique voir géopolitique, alimenter vos LLMs avec des données propriétaires sensibles via une API publique expose potentiellement ces données à des usages que vous ne contrôlez pas.

Ce que cela implique concrètement pour votre choix d’ESN

Votre ESN doit être capable de :

  • Déployer des modèles open-source (Mistral, LLaMA, Gemma) sur votre infrastructure sans dépendance à une API externe
  • Construire des architectures RAG avec un vector store auto-hébergé (Qdrant, Weaviate, pgvector) et des embeddings locaux
  • industrialiser la chaîne LLMOps avec observabilité, sécurité et traçabilité
  • Concevoir une architecture réversible, capable de changer de modèle, de fournisseur d’infrastructure ou de composant technique sans remettre à plat tout le dispositif.
  • Documenter l’architecture conformément aux exigences AI Act : registre des systèmes IA, classification par niveau de risque, garde-fous
Point de vigilance

Certaines ESN « souveraines » déploient simplement des API d’éditeurs américains dans votre VPC cloud. Ce n’est pas de la souveraineté car les données transitent toujours par les serveurs de l’éditeur. La vraie souveraineté commence au niveau du modèle.

Automatisation des pipelines data, quels attendus vis à vis de l’ESN ?

L’automatisation des pipelines data est souvent perçu comme un sujet purement technique. C’est surtout une capacité organisationnelle qui détermine la vélocité de votre SI data et la fiabilité de tout ce qui en dépend : BI, ML, IA générative.

Un pipeline data industrialisé selon les pratiques DataOps repose sur les quatre piliers que sont l’automatisation CI/CD (chaque modification de pipeline est testée et déployée automatiquement), les tests de qualité données (règles de validation, contrats de données), l’observabilité end-to-end (monitoring des latences, volumes, fraîcheur, qualité) et la gestion des environnements (developpement, staging, production clairement séparés avec rollback possible).

Nous vous invitons à poser ces questions à votre sélection d’ESN Data IA. Si la réponse est vague, il est fort probable que l’expertise le soit aussi.

ESN Data & IA à Paris mais aussi sur tout le territoire, ce que propose Smartpoint

Smartpoint est l’une des rares ESN françaises entièrement dédiées à la Data et à l’Intelligence Artificielle depuis sa création en 2006, ce qui en fait une des plus large concentration de consultants et d’experts Data et IA en France. Cette spécialisation se traduit par une profondeur d’expertise que les ESN généralistes ne peuvent pas égaler.

Nos équipes interviennent sur l’ensemble de la chaîne de valeur : architecture data cloud et modernisation des plateformes, automatisation des pipelines avec DataOps/LLMOps, IA générative industrialisée et RAG souverain, gouvernance des données conforme RGPD & AI Act.

Basés à Paris, nous intervenons sur l’ensemble du territoire français, en mode on-site, hybride ou via nos centres de compétences nearshore certifiés ISO 27001 et 27701 selon vos contraintes.

Notre agrément CIR, obtenu en décembre 2025, nous place parmi les rares ESN françaises habilitées à mener des projets Data & IA éligibles à ce dispositif fiscal, ce qui peut réduire le coût net de vos projets R&D de 30 %.

FAQ

Questions fréquentes sur les critères de choix d’une ESN Data IA

Une ESN généraliste propose la Data & IA parmi une dizaine d’autres activités. Les profils data y sont moins spécialisés, la capitalisation sur les projets data moins importante. Un pure player concentre 100 % de ses recrutements, de sa R&D et de son expérience terrain sur ce seul domaine, ce qui se traduit par des consultants plus seniors et une meilleure capacité à industrialiser.
Techniquement oui, mais le résultat sera peu fiable. Un RAG est aussi bon que les données qu’il indexe. Sur une plateforme mal gouvernée, sans qualité certifiée, sans lignage, le RAG produira des réponses hallucinées ou non traçables, impossibles à superviser en production.
L’IA souveraine désigne la capacité à opérer des modèles d’IA sur une infrastructure entièrement maîtrisée, sans dépendance à des API ou des clouds étrangers. Pour un DSI, c’est devenu stratégique pour la conformité RGPD et AI Act, pour éviter les risques de fuite de données propriétaires et pour réduire la dépendance à un fournisseur unique.
Posez trois questions précises : quel est votre framework de tests de qualité données en CI/CD ? Comment gérez-vous le versioning des pipelines et les rollbacks en production ? Quels outils utilisez-vous pour l’observabilité des flux data ? Une ESN sérieuse répondra avec des outils précis (Great Expectations, dbt tests, Monte Carlo, OpenLineage…). Une réponse vague est un signal d’alarme.
Non, il s’applique aux travaux qui visent à dépasser l’état de l’art avec une démarche expérimentale structurée. Sont typiquement éligibles : architectures data innovantes, pipelines LLMOps sur mesure, RAG avec techniques d’indexation non standardisées, agents IA autonomes. L’ESN agréée vous accompagne pour qualifier l’éligibilité de votre projet.
Metrics Layer et Semantic Layer : le socle de la BI

Les entreprises se sont presque habituées à fonctionner avec des KPI incohérents d’un tableau de bord à l’autre et les équipes s’en accommodaient. Certes c’était un irritant, parfois couteux, mais tolérable tant que la BI restait principalement consommée dans des dashboards.

Ce temps est derrière nous. La modernisation de la BI ne consiste pas à seulement remplacer un outil décisionnel par un autre, ni à migrer Cognos ou Business Objects vers une plateforme Data cloud-native. La BI moderne, ce n’est plus que de la restitution, elle alimente désormais des insights automatisés, des alertes en temps réel, des interfaces en langage naturel, des APIs analytiques, des copilotes et de plus en plus des agents IA de déclencher des actions.

Une divergence de définition n’a plus la même résonnance, elle se diffuse et pollue l’ensemble. C’est tout le sens métier qui est compromis.

C’est pour ces raisons que la Metrics Layer et la Semantic Layer sont devenus indispensables à la BI moderne. Elles sont la condition sine qua non pour qu’un indicateur conserve la même signification, quel que soit le canal sur lequel il est exposé, consommé, interrogé ou réutilisé. La vraie modernisation de la BI dépasse les considérations d’ergonomie, de vitesse, de performance ou de cloud ou pas cloud ou encore d’ergonomie ; elle passe par la construction d’un commun de sens partagé.

La BI moderne n’est plus dans le dashboard mais dans toutes les interfaces où circule le sens métier

Le principal changement est que les KPIs ne sont plus que des dans des rapports, ils circulent dans les outils métiers, les applications embarquées, les copilotes analytiques, les requêtes en langage naturel … et bientôt dans des workflows décisionnels toujours plus autonomes.

La BI est plus diffuse, conversationnelle, embarquée et agentique.

Et cela change tout en termes d’architecture Data BI. Tant que l’analyste officiait comme intermédiaire quasi incontournable entre les données et les décisions, la correction humaine était implicite. Les erreurs et autres incohérences étaient identifiées et redressées.

Mais lorsqu’un assistant IA répond directement à une question du type « quel était notre taux de churn sur le trimestre dernier ? », il ne sait pas improviser le sens métier. Il a besoin d’un cadre avec un langage métier cohérent, des définitions immuables, des relations explicites, des règles d’agrégation, des exclusions documentées et des hiérarchies compréhensibles.

Historiquement, nous avions une BI centrée sur data visualisation ; elle se déporte sur la sémantique gouvernée. Une « bonne » plateforme décisionnelle doit être aujourd’hui en capacités de garantir que le chiffre est bon, compris par tous ceux qui le consomme de la même manière quel que soit le canal utilisé. Plus la BI est augmentée, plus la gouvernance des métriques est un sujet d’architecture Data.

La Metrics Layer et la Semantic Layer ne répondent pas au même besoin mais sont indissociables

Déjà, revenons sur leurs définitions.

  • La Metrics Layer centralise la définition des indicateurs métier. Elle formalise les calculs, les agrégations, les dimensions autorisées, les filtres applicables, les exceptions, les variantes de calcul et si nécessaire, les fenêtres temporelles. Elle précise donc ce qui définit réellement le chiffre d’affaires, la marge, le stock disponible, le revenu net, le churn, le coût d’acquisition, le délai moyen de traitement ou encore le turnover. Son rôle est de remplacer les définitions éparsespar un référentiel de métriques commun, versionné, gouverné et réutilisable dans les tableaux de bord, les APIs, les requêtes en langage naturel, les copilotes et les agents.
  • La Semantic Layer organise le sens métier autour de ces indicateurs. Elle relie les métriques à des objets, à un vocabulaire partagé, à des synonymes, à des hiérarchies, à des dimensions, à des relations entre entités et à des descriptions compréhensibles par les utilisateurs métier. Elle précise donc ce que recouvrent réellement des notions comme par exemple un client actif, une commande livrée, un revenu récurrent, une marge commerciale, un stock exploitable ou un canal de vente en les replaçant dans leur contexte d’usage. Son rôle est de remplacer les interprétations par un référentiel sémantique commun, documenté, gouverné et réutilisable.

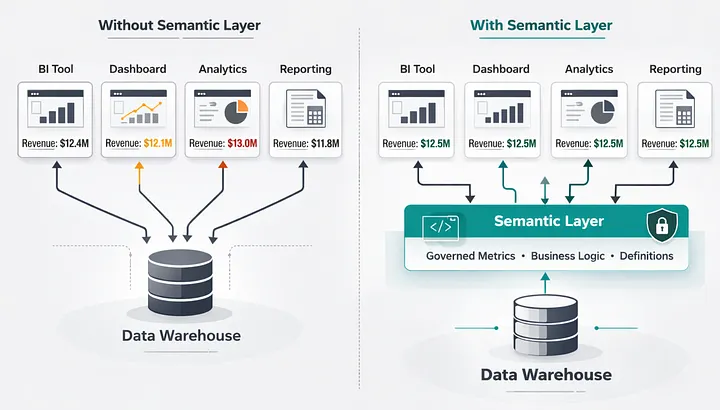
En clair, la Metrics Layer stabilise le calcul, la Semantic Layer stabilise l’interprétation. La première garantit que le chiffre est produit de façon cohérente et la seconde qu’il est compris de manière cohérente.

semantic layer

Source : Alwyn DSouza : https://medium.com/towards-data-engineering/why-data-teams-need-a-semantic-layer-83947a5a0057

Le vrai problème de l’IA n’est pas le modèle mais l’absence de sens métier exécutable

Lorsque les réponses générées par un copilote analytique ne sont pas aux attendus, la tentation est grande de condamner le modèle ou la qualité des données. Alors que dans les faits, c’est souvent lié à l’absence de contexte métier exécutable.

Une donnée structurée ne parle pas d’elle-même. Un nom de colonne, une table ou une relation physique ne suffisent pas à dire ce que signifie réellement un KPI dans l’organisation. Une IA peut repérer des schémas, émettre des hypothèses, rapprocher des concepts. Elle ne peut pas deviner par elle-même ce que votre entreprise entend exactement par revenu récurrent net, client actif, commande livrée, stock exploitable ou marge commerciale. Tant que ce sens n’est pas explicitement gouverné, versionné et exposé dans une couche réutilisable, cela ne peut pas fonctionner.

La Semantic Layer ne doit pas être vue comme une simple couche de documentation. Elle a pour rôle de rendre le sens métier directement exploitable par les systèmes. Elle formalise les définitions, les relations, les hiérarchies et les contextes nécessaires pour qu’une plateforme BI, une API analytique, une interface en langage naturel, un copilote ou un agent IA interprète les données de façon cohérente. La semantic Layer est une brique d’architecture à part entière, au croisement de l’analytics, de la gouvernance et de l’AI readiness.

Attention à la dérive sémantique !

Il ne suffit pas d’ajouter une couche sémantique. Encore faut-il qu’elle reste alignée dans la durée sur le modèle physique, sur les transformations opérées et sur les règles métier en production. Sans cela, la plateforme donne une impression de cohérence alors qu’elle diffuse en réalité un sens devenu obsolète.

Une métrique peut rester exposée alors que son calcul a changé. Une relation logique peut rester documentée alors qu’elle ne reflète plus la chaîne de traitement réelle. Une colonne renommée peut ne pas être répercutée correctement. Un libellé métier peut perdurer alors que son périmètre a évolué. La couche sémantique cesse alors d’être ce facteur de stabilité pour devenir une source invisible d’écart.

Dans le cas des dashboards traditionnels, cette dérive produisait des analyses non pertinentes. Dans un univers de BI conversationnelle, de copilotes et d’agents, c’est particulièrement critique. Une réponse fausse mais fluide dégrade la confiance plus vite qu’une absence de réponse.

La dette BI n’est donc plus seulement une dette de pipelines, d’outils ou de restitution. C’est aussi une dette de sémantique. Moderniser la BI, c’est réduire cet écart entre calcul réel, définition métier et interprétation exposée.

Le RAG, les copilotes et les agents ne remplacent pas une couche sémantique gouvernée

Le RAG ne remplace pas la sémantique. Un copilote connecté à de la documentation interne peut très bien retrouver une définition ou expliquer une règle métier. C’est utile mais cela ne suffit pas à garantir la cohérence d’un KPI dans un environnement décisionnel moderne.

Si la logique de calcul est disséminée (requêtes SQL, tableaux de bord, exports Excel..), l’IA ne va rien arranger du tout, elle va au contraire fluidifier l’accès à des bases instables.

Pour que la BI augmentée soit fiable, elle doit s’appuyer sur plusieurs briques : données fiables, chaîne de transformation maîtrisée, métriques versionnées, couche sémantique documentée, data lineage, contrôle d’accès, observabilité, puis seulement des interfaces de restitution ou de conversation.

La bonne architecture, ce n’est pas trancher entre dashboard ou copilote, ni entre RAG et semantic layer. C’est une architecture Data dans laquelle la couche sémantique a un rôle de pivot entre la plateforme data, la BI moderne et les usages IA. Sans cela, la requête en langage naturel, le digest automatisé ou l’agent analytique diffusera des informations possiblement erronées, et ce à grande vitesse. (À lire sur ce sujet « Your Data Architecture Is Ready. Your Semantic Layer Isn’t. Here’s Why That’s the Real AI Problem.« 

Les symptômes d’une plateforme BI sans Metrics Layer

On se rend vite compte au quotidien si votre plateforme BI repose bien sur une Metrics Layer ! Les équipes finance, commerce et opérations utilisent des chiffres différents pour décrire une même réalité. Le self-service BI est resté largement théorique, dès qu’une question est sensible, tout le monde se tourne vers les deux ou trois experts historiques. Les projets de migration de legacy BI sont laborieux non pas à cause du volume de rapports mais par ce que les règles métier sont implicites et disséminées dans les dashboards, les requêtes SQL, les exports Excel ou les habitudes des équipes. Elles n’ont jamais été formalisées dans un référentiel commun, au mieux partiellement.

Et c’est précisément là que la dette analytique fait son nid. Le patrimoine décisionnel d’une entreprise n’est pas que dans les outils, les rapports ou les pipelines, il est aussi dans la logique métier accumulée au fil des années. Ainsi, remplacer tel outil BI par un autre ne suffit pas. On modernise l’interface, parfois le run, mais sans repenser le socle de sens qui va soutenir tous les usages.

C’est aussi l’un des constats que nous faisons chez Smartpoint, ESN spécialisée en Data et IA.

la dette de la plateforme décisionnelle ne vient pas seulement d’outils vieillissants, d’ETL historiques ou de l’architecture data. Elle vient tout autant de la dispersion du sens métier, sans point de gravité clair, sans gouvernance unifiée des métriques et sans couche commune pour stabiliser les définitions. Tant que cette dette n’est pas traitée, la modernisation n’aura pas lieu. Il est important de palier à l’absence d’un référentiel de métriques partagé, gouverné et exploitable dans toute la chaîne BI et IA.

Partir des KPI critiques et reconnecter la sémantique à l’architecture

Chez Smartpoint, ESN spécialisée en Data et IA, nous vous conseillons de ne pas vous lancer tout de suite dans un vaste programme de glossaire métier !

Mieux vaut vous concentrer sur les KPI critiques, c’est-à-dire sur ceux qui sont les plus exposés dans l’entreprise : comités, tableaux de bord, exports, alertes, requêtes en langage naturel, APIs, outils métiers, copilotes, agents et applications embarquées. Ce sont eux qui portent le plus de valeur, mais aussi le plus fort risque de divergence.

La bonne démarche consiste d’abord à identifier ces métriques, à versionner leur définition, à documenter les hypothèses, les filtres, les règles d’exclusion et les exceptions, à désigner des owners, puis à relier ces objets à la qualité des données, au data lineage, aux droits d’accès et au change management de la plateforme. La couche sémantique ne doit plus rester à côté de l’architecture data, elle doit devenir une brique du modèle opérable.

C’est aussi ce qui distingue une approche purement aval d’une approche plus proche du design-time. Plus la sémantique est éloignée de la modélisation physique, des transformations et des workflows de changement, plus le risque de dérive augmente. À l’inverse, plus la gouvernance des métriques, le lineage, la qualité et la sémantique sont rapprochés, plus la plateforme décisionnelle gagne en stabilité. L’enjeu n’est donc pas seulement de mieux documenter mais d’intégrer la sémantique au cœur même du cycle de changement.

`

Définir le sens une fois, le réutiliser partout

Au niveau des éditeurs, tous convergent vers une même direction : définir les métriques et le contexte métier une fois, puis les réutiliser dans les tableaux de bord, les usages conversationnels, les APIs et les cas d’usage IA.

  • Chez Microsoft, lorsqu’une question porte sur les données, Copilot s’appuie sur le modèle sémantique Power BI pour répondre.
  • Chez dbt, la Semantic Layer centralise les définitions de métriques dans la couche de modélisation et les rend cohérentes dans les outils et les applications.
  • Google Cloud présente quant-à-lui Looker comme une plateforme orientée API, dotée d’une couche sémantique et d’une interface en langage naturel, tandis que sa documentation indique que Conversational Analytics s’appuie sur la couche sémantique LookML comme source de vérité.
  • Snowflake explique que ses Semantic Views rapprochent les données brutes de la compréhension métier et fournissent une couche cohérente pour Cortex Analyst, les outils BI et même SQL.
  • Databricks, de son côté, positionne ses Metric Views comme un moyen centralisé, gouverné et réutilisable de définir les KPI, puis d’y ajouter des métadonnées sémantiques utiles aux tableaux de bord AI/BI et aux interfaces en langage naturel.
  • Chez Tableau, on “traduit les données dans le langage de l’entreprise”, tandis que Tableau Pulse pousse les métriques directement dans Slack, Teams et les e-mail.
  • Qlik parle moins semantic layer mais la logique est proche : Qlik Answers mixe analytics et contenu non structuré pour produire des réponses contextualisées et explicables, avec citations des sources, tandis que Qlik Cloud Analytics distribue analytics, IA, data products, embedded analytics et orchestration.

A lire sur ce sujet pour aller plus loin :

Et bientôt l’interopérabilité sémantique ?

Si la couche sémantique devient le pivot des produits analytics, dashboards, copilotes, agents et interfaces en langage naturel, un nouveau risque émerge : recréer un vendor lock-in au niveau même du sens métier.

C’est pourquoi l’interopérabilité sémantique devient un enjeu majeur. Sa portabilité comptera bientôt autant que celle des données elles-mêmes. Le sujet dépasse la technique : il touche à la gouvernance, la réversibilité, l’architecture cible et la capacité à faire évoluer la plateforme sans enfermer l’entreprise dans une nouvelle dépendance.

Moderniser la BI, c’est fiabiliser l’architecture décisionnelle

Aujourd’hui, moderniser la BI ne consiste pas à ajouter un énième outil de restitution, mais à bâtir une plateforme décisionnelle garantissant un sens métier unifié. Et cela demande de concevoir un socle solide : données fiables, chaîne de transformations maîtrisée, métriques versionnées, couche sémantique, data lineage, observabilité et contrôle d’accès.

Metrics Layer pour réduire la dette analytique.
Semantic Layer pour relier définitions métier et architecture data.
Cette articulation ouvre le chemin d’une BI statique à une BI exploitable à l’échelle, y compris en conversationnel et IA.

Chez Smartpoint, spécialiste Data & IA, nous sommes convaincus qu’on ne modernise pas durablement la BI en changeant l’outil. On la reconstruit avec un socle de sens gouverné, réutilisable et opérable dans toute la chaîne décisionnelle.

Quelle différence entre Metrics Layer et Semantic Layer ?

La Metrics Layer stabilise le calcul des KPI. la Semantic Layer stabilise leur interprétation métier.

Pourquoi la couche sémantique est critique pour l’IA ?

Parce qu’un copilote ou un agent IA ne peut pas deviner seul ce que signifie un indicateur dans votre entreprise.

Le RAG remplace-t-il la couche sémantique ?

Non. Le RAG aide à retrouver du contexte documentaire, mais il ne remplace pas une définition gouvernée des métriques.

BI augmentée, RAG, copilotes : la nouvelle stack décisionnelle

Auteurs : Luc Doladille et Emmanuelle Parnois

Quand on parle de BI, on pense rapports, dashboard, KPI et requêtes plus ou moins complexes. Le self-service BI a permis un accès plus simple aux données et a ouvert la porte à plus d’autonomie des métiers. Mais ce qui change profondément la BI, c’est l’IA.

On peut maintenant interroger les données en langage naturel, générer des analyses à la demande, produire automatiquement des narratifs, détecter des anomalies, simuler des scénarios et, de plus en plus, déclencher des actions.
La BI a aussi adopté l’IA générative. Tous les éditeurs vont dans le même sens : requêtes en NLQ, copilotes analytics, recommandations contextuelles, résumés automatiques, interfaces conversationnelles, assistants de Data Viz et orchestration de certaines étapes d’analyse.

Fini la BI descriptive qui se résumait à de la restitution. Désormais, elle explique, compare, alerte et propose des actions.

En revanche, si l’interface devient conversationnelle, le socle lui doit être renforcé pour ne pas générer des erreurs et autres hallucinations avec une portée inégalée. Une mauvaise réponse formulée avec beaucoup d’assurance par un copilote conversationnel est particulièrement inacceptable sur des KPI métiers, des données financières, des niveaux de stocks par exemple ou encore des prévisions.


Plus l’IA facilite l’accès à l’analyse, plus la gouvernance, la couche sémantique, le data lineage, le RAG et la maîtrise de la plateforme BI sont critiques.

Luc Doladille, Directeur Conseil Data IA, Smartpoint

De la BI self-service à la BI augmentée par l’IA

La BI en libre service est devenu un standard ces dernières années avec Power BI, Qlik Sense ou encore Tableau ; même si les vrais usages en volume côté métiers sont encore à la marge dans les organisations que nous accompagnons. L’IA vient de faire basculer d’un coup la Data Viz dans une autre dimension. On n’en est plus à consulter ni à créer des dashboards, on dialogue désormais avec les données.

Copilot est maintenant intégré à Power BI et permet de retrouver des rapports, d’interroger des modèles sémantiques et des agents de données Fabric, et d’assister l’utilisateur dans son analyse (Lire Copilot dans l’intégration de Power BI). De son côté, Tableau Agent (anciennement Tableau Pulse et Einstein Copilot) promet l’autonomie analytique des métiers via l’exploration en langage naturel, l’instanciation automatique de visualisations, la capacité de mener des calculs complexes et la recommandation contextuelle de pistes d’analyse. Qlik Answers va encore plus loin dans l’analytique conversationnel en permettant l’exploitation des données structurées et des bases documentaires métiers non structurées avec un système de citation des sources.

La BI sort de son périmètre historique et passe à l’Analytics Agentique, proactive et prescriptive. Elle ne se contente plus de livrer des chiffres, elle commence à expliquer les écarts, à formuler des hypothèses prédictives, à signaler des anomalies en temps réel et, dans les architectures Data les plus modernes à orchestrer les actions métier.

Chez Smartpoint, ESN spécialisée en Data et IA, nos experts BI observent d’ailleurs une convergence technologique chez les acteurs historiques :

  • Qlik et l’IA gouvernée : Qlik met en avant des réponses gouvernées et explicables comme socle indispensable de l’analytics agentique. Pour une DSI, c’est un garde-fou car cela suppose que l’action suggérée par l’IA repose bien sur un Data Lineage vérifiable.
  • Microsoft et les Translytical task flows : Microsoft met en avant des flux de tâches dits « translytiques » dans Power BI dont la finalité est de casser le silo entre analyse et opérationnel en permettant, directement depuis un rapport, de mettre à jour des enregistrements dans le CRM ou de déclencher des automatisations via Power Automate
  • Tableau et l’Agentic Analytics Platform : La solution de Salesforce se positionne désormais comme une plateforme analytique agentique où l’IA ne répond pas seulement à une question, elle est un agent capable de naviguer dans les données pour identifier des causes racines et suggérer des remédiations immédiates.

Qu’est ce que l’IA générative apporte à la BI ?

C’est le développement du NLQ (Natural Language Query) qui a vraiment changé la nature des usages BI. Plus besoin de requêtes SQL, on peut parler en langage métier, cela démocratise enfin les usages et surtout cela permet à une plus large population de l’entreprise d’exploiter les données. Copilot peut répondre sur des rapports, des modèles sémantiques ou des agents de données Fabric. Tableau Agent peut transformer des prompts en visualisations et en calculs. La BI est plus accessible au plus grand nombre … mais encore plus dépendante de la qualité des données qui alimentent l’interface.

Ensuite, la narration automatisée permet à la BI augmentée de raconter ce qu’elle voit. Tableau déploie des résumés de dashboards et des améliorations de Q&A. Qlik Answers produit des réponses explicables basés sur des bases documentaires. Microsoft positionne Copilot comme un assistant capable de résumer et de guider l’analyse. Ce passage du visuel au récit change la perception même de la BI.

Le troisième changement est plus fondamental. On est en train de glisser d’une BI essentiellement descriptive vers une BI plus prédictive, prescriptive et opérationnelle : Détection d’anomalies, scénarios « what-if », prévisions, exploration contextuelle, alerting plus intelligent, recommandations. Tableau promet des capacités de prévision toujours plus fines et une analyse temps réel plus granulaire. Power BI rapproche de plus en plus analyse et action via les task flows. Qlik pousse une logique où la conversation ne s’arrête pas à la réponse, mais peut aboutir à la prochaine étape. Clairement, c’est toute la boucle OODA du pilotage qui s’accélère : observer, s’orienter, décider, agir.

La BI traditionnelle ne disparaît pas, elle se réinvente.

La Business Intelligence évolue à vitesse grand V. L’essor de l’IA générative interroge, va-t-elle remplacer la BI ? La réponse est non.

Comme sur d’autres sujets, l’IA vient automatiser les tâches de premier niveau : retrouver un rapport, générer un commentaire, résumer une tendance, proposer un visuel ou encore suggérer des pistes d’exploration. Le gain de productivité est considérable, mais il ne remplace pas les KPI certifiés, les règles de gestion, la granularité métier, la logique de consolidation ni les arbitrages humains.

En réalité, plus l’interface utilisateur se simplifie, plus la sémantique et le modèle analytique sous-jacent deviennent stratégiques.

La BI entre dans une nouvelle ère.

La BI que nous connaissions, longtemps perçue comme un “écran final”, devient désormais une infrastructure centrale, garante de la confiance dans les données. Les data products analytics de Qlik, les semantic models de Power BI ou la sémantique gouvernée de Tableau en sont des illustrations : tous visent à bâtir le socle d’une BI augmentée et gouvernée.

Car une question posée en langage naturel n’est pertinente que si le système sait exactement ce qu’est une marge, un churn, un lead qualifié ou un stock disponible. En d’autres termes, la conversation ne remplace pas le socle : elle le met à nu.

Chez Smartpoint, nos experts Data IA voient dans cette mutation une formidable opportunité : replacer la BI au cœur de l’écosystème data et lui redonner sa mission première : rendre la donnée fiable, accessible et intelligible dans un monde piloté par l’IA.

La différence entre BI Traditionnelle et BI Augmentée

FonctionnalitésBI traditionnelleBI augmentée (2026)
Interface utilisateurDashboards statiques, requêtes SQL, self-service limité (Power BI, Qlik Sense, Tableau) Conversationnelle en NLQ, copilotes (Copilot Power BI, Tableau Agent, Qlik Answers), narration automatique et task flows
Usages principauxDescriptive (KPI, rapports, restitution)Prédictive/prescriptive : anomalies, what-if, alerting temps réel, actions auto (OODA accéléré), analytics agentique
Socle techniqueModèles analytiques basiques, data vizCouche sémantique (metrics layer, semantic models), RAG, data lineage (Purview/Fabric), gouvernance critique (OneLake, Rule-Based Semantic)
ProductivitéAutomatisation limitée, métiers dépendants de la DSIGain énorme : NLQ, résumés automatisé, data viz par prompt
Accessible à tous mais attention à la « surconfiance »
RisquesErreurs visibles (filtres absents, data viz incohérentes)Hallucinations plausibles sur KPI métiers (LLM fallback), erreurs amplifiées
Exige vérification humaine
Gouvernance requiseBasique (accès, fraîcheur données)Avancée : sémantique transverse, auditabilité, traçabilité sources, conformité AI Act/SecNumCloud
PlateformesPower BI, Qlik Sense, TableauMicrosoft Fabric (convergence), Qlik (agentique gouverné), Tableau (exploration IA), DigDash (souveraineté)

Le vrai danger ? « Halluciner » sur des KPI métiers

Le risque majeur de cette nouvelle BI augmentée ne réside pas seulement dans l’erreur ; il réside dans l’erreur plausible.

Autrefois, un tableau de bord mal conçu laissait quelques indices : absence de filtres, doutes sur la source, visualisation incohérente… Aujourd’hui, un copilote conversationnel peut produire une réponse concise, convaincante … et complètement fausse. Et une mauvaise réponse formulée avec assurance par un copilote est inacceptable. Chez Smartpoint, nous considérons que le déploiement d’un Semantic Link ou d’un Metrics Layer n’est plus une option mais un prérequis de sécurité opérationnelle

La documentation de Microsoft Copilot est explicite sur le sujet : selon la requête, l’outil peut s’appuyer sur le modèle sémantique de l’entreprise ou, dans certains cas, sur les connaissances générales du LLM. Sans ancrage solide dans la donnée métier, le système ne livre pas nécessairement la vérité métier, il fournit une réponse statistiquement plausible.

Dans le cas de KPI financiers, de prévisions de ventes ou de stocks critiques, cela peut avoir des conséquences lourdes.

Les causes sont souvent basiques : indicateurs mal définis, fraîcheur, documentation non mise à jour, données incomplètes, configuration de sécurité défaillante, confusion entre plusieurs versions d’un KPI ou périmètre d’analyse insuffisament précis

Et la conversation masque la faiblesse du socle. Plus l’interface est fluide et “propre”, plus le risque de surconfiance augmente. Ce n’est pas un hasard si Qlik met l’accent sur la traçabilité et l’explicabilité ou si Tableau recommande une revue humaine systématique des réponses générées par l’IA.

La BI augmentée offre un gain de temps considérable mais elle peut aussi accélérer la diffusion d’une erreur avec une assurance déconcertante.

Chez Smartpoint, nos experts Data et IA sont convaincus que la vraie puissance de l’IA dans la BI n’est pas dans la génération instantanée de réponses, mais dans la solidité du socle qui les rend justes, auditées et explicables.

Pourquoi la gouvernance est au coeur cœur de la nouvelle stack décisionnelle

Longtemps considérée comme une annexe des projets data, la gouvernance des données devient aujourd’hui la condition sinequanone de la fiabilité dans une BI conversationnelle et augmentée.

1. La couche sémantique, le socle de confiance

La première brique de cette nouvelle architecture décisionnelle, c’est la couche sémantique transverse : metrics layer, glossaire métier, définitions partagées, objets certifiés, sécurité d’accès, règles de calcul explicites. C’est elle qui permet de parler le même langage, de Power BI à Tableau ou encore Qlik.

Microsoft pousse cette logique encore plus loin. Les Semantic Models, le catalogue OneLake et Semantic Link renforcent l’interopérabilité entre IA, BI et data engineering autour d’une couche partagée et gouvernée. Tableau, de son côté, étend en 2026 son Rule-Based Semantic Model Authoring pour élargir les modèles tout en conservant des règles d’accès maîtrisées. Qlik adopte une approche différente, mais complémentaire qui consiste à fournir des réponses gouvernées, explicables et réutilisables pour l’analytics agentique.

2. Le catalogue, le lineage et l’auditabilité

Deuxième brique, la traçabilité et la gouvernance opérationnelle. Microsoft intègre désormais Purview et Fabric pour offrir une gestion unifiée : traçabilité, classification, labels de sensibilité, protection et audit des données. OneLake sert de datalake unifié et logique avec un catalogue centralisé accessible depuis plusieurs points d’entrée. Cette approche est essentielle pour la BI augmentée car une bonne réponse ne doit pas seulement sembler juste, elle doit être rattachable à une chaîne de transformation, une source identifiée, un propriétaire et un gestion des droits sous contrôle.

3. Le RAG, le maillon intelligent

Enfin, le Retrieval-Augmented Generation (RAG) trouve naturellement sa place dans la stack décisionnelle. Dans la BI, il ne remplace pas le modèle analytique, il l’enrichit. Son rôle est de rattacher chaque réponse à un contexte validé : définition du KPI, règle de gestion, note de clôture, référentiel produit ou encore procédure métier.

Des outils comme Qlik Answers incarnent cette nouvelle approche : mélange de données structurées, documents certifiés, citations et explications de raisonnement. Bien employé, le RAG devient un levier puissant de transparence. Mal utilisé, c’est un cache-misère sur un socle instable…

Chez Smartpoint, nous voyons dans cette convergence entre couche sémantique, documents vérifiés et gouvernance renforcée comme les fondements d’une BI “AI-ready” , c’est à dire une BI capable d’exploiter l’IA sans renoncer à la rigueur, à la traçabilité ni en la confiance dans les données.

Quelle plateforme choisir une BI augmentée crédible ?

Souvent, nos clients nous demandent « Quelle est la plateforme la plus innovante ? » alors que la vraie question est plutôt « Quelle plateforme est la mieux alignée avec l’architecture data cible, le niveau de maturité en matière de gouvernance, les contraintes réglementaires et le modèle opérationnel que l’entreprise souhaite mettre en place ? »

En 2026, tous les éditeurs affichent une feuille de route IA très ambitieuse. La question n’est donc pas de savoir qui fait de l’IA dans sa solution, mais avec quel socle décisionnel et quelle gouvernance.

Microsoft, la convergence dans l’écosystème

Microsoft Fabric et Power BI sont (presque) incontournables si votre organisation est déjà ancrée dans l’écosystème Microsoft. Cette combinaison permet de rapprocher, au sein d’un même environnement, le data lake, les modèles sémantiques, la gouvernance et l’action.

  • OneLake offre un data lake unifié dédié à la donnée d’analyse.
  • Direct Lake optimise l’exploration interactive sur de gros volumes directement depuis OneLake.
  • Power BI ajoute des usages plus opérationnels, notamment via les task flows, qui rapprochent la donnée et l’action.

Cette intégration renforce la sémantique gouvernée, la cohérence et la fiabilité des analyses.

Qlik , la gouvernance et les analytics “agentique”

Qlik se distingue par son approche pour une BI augmentée gouvernée. La plateforme pousse le concept d’analytics agentique, c’est à des réponses contextualisées, expliquées, sourcées et réutilisables avec une priorité sur la traçabilité et à la qualité des données. Chez Smartpoint, nos experts Data et IA considèrent également que la gouvernance est le nerf de la guerre dans cette nouvelle génération de BI powered-by-IA.

Son ouverture aux données structurées et non structurées, ainsi que ses capacités avancées d’analytics et de machine learning en font un très bon choix de plateforme pour les organisations qui priorisent une autonomie analytique solide et surtout traçable.

Tableau, l’exploration augmentée au service des analystes

Tableau conserve sa longueur d’avance historique sur l’expérience Analyste et l’exploration intuitive. Les nouvelles fonctionnalités IA permettent notamment :

  • La génération de data visualisations à partir de prompts en langage naturel
  • Des résumés automatisés de tableaux de bord,
  • Le renforcement de la sémantique gouvernée pour assurer la cohérence et la fiabilité des analyses

Tableau reste une référence pour les équipes qui privilégient créativité, rigueur analytique et gouvernance.

DigDash, l’alternative française souveraine et « AI-Native »

Clairement, pour nos expert Data IA, DigDash est en train de s’imposer comme une réponse stratégique aux enjeux de souveraineté. L’éditeur a pris de front la convergence Data/IA en intégrant l’IA au cœur de son moteur analytique. À Lire Souveraineté des données : le cas oublié de la business intelligence par DigDash.

  • DigDash Agent & NLQ : L’assistant conversationnel permet de générer des visualisations et des analyses complexes en langage naturel sans compromis sur la rigueur du modèle de données.
  • Analytics Prédictif : Régressions, lissages, calculs statistiques avancés pour passer de la BI descriptive au prédictif.
  • Souveraineté « by design » : Face à l’AI Act et aux exigences SecNumCloud, DigDash offre une maîtrise totale de l’hébergement et des flux, échappant nativement aux contraintes du Cloud Act.

Le choix d’une plateforme Data souveraine ? Un critère de plus en plus déterminant pour les DSI françaises

Rappelons que L’AI Act est entré en vigueur le 1er août 2024 et sera pleinement applicable à partir du 2 août 2026 avec certaines obligations déjà actives. En parallèle, l’ANSSI est oeuvre sur l’extension de périmètre de NIS 2 alors que les exigences de gestion du risque cyber ne cessent de croitre. Aujourd’hui, intégrer l’auditabilité, la traçabilité, la gouvernance des accès, la localisation des flux et la maîtrise des dépendances sont en passe de devenir des critères en termes d’architecture Data / IA.

Le sujet de la souveraineté ou de l’hybridation des plateformes Data n’est plus anecdotique. Pour une DSI française, le choix d’une plateforme souveraine devient un critère de résilience.

Nos experts Data IA accompagnent d’ailleurs de plus en plus d’organisations dans la conception d’architectures hybrides qui exploitent la puissance de calcul des LLM mondiaux et le stockage sécurisé sur des environnements qualifiés SecNumCloud.

Luc Doladille, Directeur Conseil, Smartpoint

D’ailleurs, Microsoft précise que Copilot n’est pas encore pris en charge dans les clouds souverains. À l’inverse, OVHcloud met en avant ses offres et ses environnements SecNumCloud ainsi que ses engagements sur le traitement des données dans l’Union européenne. Scaleway, de son côté, communique sur son entrée officielle dans le processus de qualification SecNumCloud. L’offre n’est pas encore mature mais le sujet est bel et bien posé.

Alors, la BI survivra-t-elle à la déferlante de l’IA générative ?

La réponse est un oui ! Mais attention, la BI augmentée n’est pas une nouvelle génération dataviz conversationnelle. C’est un socle décisionnel gouverné, l’infrastructure de confiance indispensable pour alimenter les copilotes, les agents et le RAG sans sacrifier la fiabilité métier.

En 2026, la nouvelle stack décisionnelle n’est pas une simple addition de BI et d’IA. C’est une fusion cohérente entre BI augmentée, couche sémantique, RAG, gouvernance et plateforme opérable.

La véritable valeur d’un SI Data réside ans sa capacité à produire une réponse vraie, explicable, traçable et défendable. Ce qui fait aujourd’hui la différence sur le terrain, c’est l’implémentation rigoureuse d’un metrics layer, d’un glossaire métier unifié, d’un lineage exploitable et d’un RAG bien discipliné.

Chez Smartpoint, nous accompagnons les directions IT pour bâtir ces garde-fous, concevoir et mettre en oeuvre des plateformes Data IA qui tiennent la charge en production. Car dans un monde piloté par l’IA, le chat ne vaut rien sans un socle de vérité inébranlable !

En bref

Qu’est-ce que la BI augmentée ?

La BI augmentée désigne une business intelligence enrichie par l’IA, le langage naturel, les copilotes et l’automatisation de certaines analyses pour accélérer l’accès aux insights.

Pourquoi le RAG est important dans la BI ?

Le RAG permet de rattacher une réponse à des documents, à des règles de gestion ou à des définitions métier validées. Il renforce la traçabilité et limite les réponses seulement plausibles.

Pourquoi la gouvernance est incontournable dans une BI conversationnelle ?

Parce qu’un copilote analytique peut produire une réponse convaincante mais erronée si les KPI, la couche sémantique, le lineage ou les droits d’accès ne sont pas maîtrisés.

Migrer Cognos, Business Objects ou Talend en 2026 : les étapes pour moderniser la BI sans casser le run

En 2026, la modernisation de la BI est devenue un chantier prioritaire pour de nombreuses DSI. Il faut en effet réussir à faire évoluer le SI décisionnel sans recréer la dette qu’on cherche justement à réduire.​ Il faut garantir la continuité de service tout en réduisant la dépendance éditeurs et les coûts (licences, MCO) tout en gagnant en sécurité et en auditabilité. Côté CDO, l’enjeu est la cohérence des KPI, le time-to-data, la qualité des donnée, le self-service BI mais gouverné et l’exploitation de l’IA.

Le problème n’est pas seulement l’âge de Cognos, SAP Business Objects ou Talend, mais la somme des problèmes accumulés au fil des ans : rapports critiques non documentés, univers et couches sémantiques sur-sollicités, jobs Talend qui encapsulent une logique métier implicite, KPI “identiques” mais divergents, usages multipliés sans gouvernance des données adaptée.​

Une migration Cognos, SAP BusinessObjects ou Talend ne peut donc pas être appréhendée comme un simple projet de remplacement d’outil “lift-and-shift”. C’est un projet de rationalisation du patrimoine décisionnel, de reconstruction de la logique métier et de modernisation globale.​

Et l’urgence est réelle : Cognos Analytics 11.2.x sort du support standard au 30 avril 2026, Talend 7.3 est déjà en fin de vie avec un support étendu achetable jusqu’à décembre 2026, et SAP pousse les clients BI 4.3 vers BI 4.3 SP5 ou BI 2025 pour rester à jour sur les standards de plateforme, de connectivité et de sécurité.​

La bonne question n’est donc pas “Par quoi remplacer Cognos, BO ou Talend ?”, mais “Comment migrer sans compromettre le run, sans perdre la confiance des métiers et sans recréer une nouvelle dette décisionnelle dans un outil plus récent ?”.

Étape 1 : Cartographier le patrimoine décisionnel réel (et non supposé)

La première erreur classique en migration Cognos, SAP BusinessObjects ou Talend est de démarrer par le choix de la cible (Power BI, dbt, Fabric…). L’outil est secondaire, le patrimoine décisionnel est prioritaire.

Chez Smartpoint, nos experts data commencent toujours par une cartographie exhaustive du patrimoine BI réel :

  • Rapports actifs vs rapports dormants (la plupart sont rarement utilisés)
  • Univers, packages et couches sémantiques réellement sollicités
  • Jobs Talend critiques pour l’alimentation des référentiels
  • Dépendances entre reporting, transformations et KPI sensibles (finance, supply, conformité)
  • Jeux de données exposés aux métiers et leurs métadonnées​​

Pourquoi cette phase est critique ? Dans les environnements legacy, l’outil n’est que la façade. La vraie complexité se cache dans les règles métier implicites, les enchaînements de traitement et les contournements historiques. On ne migre pas des dashboards. On migre un système de preuve décisionnel.

Étape 2 : Sélectionner ce qu’il faut migrer, fusionner, refondre ou supprimer

Migrer Cognos, BusinessObjects ou Talend, c’est d’abord sélectionner. Nos experts migration BI catégorisent le patrimoine en 4 catégories :​​

CatégoriesDéfinitionExemples
MigrerUsage stable, logique métier fiableRapports financiers consolidés, KPI de pilotage critiques
FusionnerPlusieurs rapports/traitements couvrent le même besoin3 rapports CA “identiques” issus de sources divergentes
RefondreLogique métier valide mais construction legacy inadaptéeUnivers BO/Cognos ou jobs Talend à réingénier
SupprimerNon utilisé, obsolète ou non certifiéRapports dormants

Le ROI est immédiat. Cette rationalisation réduit de 50% en moyenne le périmètre de migration, les coûts et la dette BI. Dans les environnements Cognos ou BO legacy, une large part du patrimoine est redondante ou obsolète.

Étape 3 : Extraire la logique métier AVANT de migrer l’outil

C’est une étape trop souvent sous-estimée en migration Cognos, Business Objects ou Talend. Les DSI expriment le besoin simplement : “Migrer BO vers Power BI” ou “Sortir de Cognos”. On pense rapports, interfaces, performances… alors que la vraie difficulté est généralement dans la logique métier encapsulée.​

Les DSI sous-estiment systématiquement l’étape critique : extraire la logique métier cachée dans Cognos/BO/Talend.

Luc Doladille, Directeur Conseil Data IA, Smartpoint


​

Où se cache cette logique métier ?

OutilsLogique métier encapsuléeExemples
CognosRègles de calcul complexes, packages sémantiquesAgrégations hiérarchiques, jointures historiques
BusinessObjectsUnivers sur-sollicités, filtres implicitesDéfinitions KPI métier, règles de scoping
TalendChoix métier ETL, contrôles qualitéExceptions non documentées, arbitrages métier

Pour Talend, c’est encore plus critique. Les chaînes d’intégration contiennent des choix métier critiques, des contrôles qualité, des exceptions, voire des arbitrages non documentés. Remplacer Talend sans extraire cette logique, c’est tout simplement déplacer la dette sans la comprendre.​

À cette étape, Smartpoint livre une base de connaissance métier et technique indépendante de l’outil source (prête à être intégrée dans Power BI, Fabric ou autre plateforme Data cible)  comprenant les règles de calcul, les définitions des KPI et les contrôles métier.

Étape 4 : Architecture cible brique par brique (jamais monolithe)

Une migration BI réussie ne consiste pas à remplacer un monolithe par un autre. Nos architectes data s’attachent à concevoir une architecture BI modulaire et gouvernable.

Les 5 briques essentielles :

  • Stockage / calcul : Adapté au volume et à la fréquence (lakehouse Snowflake / Fabric)
  • Transformation : ELT moderne (dbt, Databricks)
  • Metrics Layer : sémantique unifiée et versionnée (KPI cohérents)
  • Exposition analytique : headless BI (Power BI, Tableau et API)
  • Gouvernance : qualité, observabilité, sécurité, lignage

Le piège fréquent à ce stade est de se focaliser sur une suite BI en particulier. Faire par exemple de Power BI la réponse à tout. Power BI est un bon outil de restitution et de self-service BI gouverné mais il ne gère pas de transformation lourde ni la gouvernance complexe de KPI.

Même chose pour Talend. Passer à dbt, à un ELT cloud ou à une nouvelle plateforme data n’a de valeur que si on a qualifie en amont ce que l’on transforme, pourquoi, à quelle fréquence, avec quels tests et pour quels consommateurs des données (Outils ETL Open source).

Selon nos consultants spécialisés en architectures de data modernises, le sujet n’est pas quel outil choisir mais quelles briques moderniser et son niveau d’autonomie dans la plateforme Data globale (Data Mesh, Data Fabric). D’ailleurs, la réalité est souvent best-of-breed.

Étape 5 : Cutover progressif, pas de big bang

Il est évidemment hors de question de « couper » Cognos, BO ou Talend du jour au lendemain. La modernisation BI passe obligatoirement par une coexistence temporaire maîtrisée entre legacy et plateforme data cible.

Pour ce, nos consultants en migration Data cadrent systématiquement :

  • Les lots qui doivent migrer en priorité (KPI critiques, rapports métiers)
  • Les usages Legacy maintenus pendant la transition
  • La version du KPI faisant foi (legacy ou cible)
  • La gestion d’éventuels double calculs (seuils d’écart, arbitrage automatique)
  • La manière dont les écarts doivent être gérés (reprise manuelle, alertes, investigations)

Sans ce cadrage préalable, l’équipe Data se retrouvent à piloter deux environnements, deux vérités possibles des mêmes KPI et la confiance utilisateurs de dégrade ce qui risque de nuire à la nouvelle plateforme avant même qu’elle ne soit déployée.  

Étape 6 : Refactoring dans des standards modernes

Une migration Cognos, BO ou Talend, c’est surtout une occasion inespérée de prendre le temps de remettre à plat tous les standards qui n’avaient jamais été formalisés. Concrètement, cela veut dire industrialiser pour ne pas reproduire la dette BI dans la plateforme cible :

  • Versionning des développements (Git pour rapports et ETL)
  • Tests automatisés (unitaires, intégration)
  • Documentation des flux et des transformations (lineage automatique)
  • Règles métier explicites (metrics layer documenté)
  • Séparation des environnements (développement, test et production)
  • Observabilité des pipelines (alerting, monitoring temps réel)
  • Contrôles qualité industrialisés (SLO data quality)

Une migration devient le chantier de delivery qui reconstruit la chaine de confiance. C’est l’opportunité de faire entrer le SI décisionnel dans une logique de plateforme data moderne (data mesh, data products, gouvernance fédérée)

Étape 7 : Valider les KPI avec les métiers

Beaucoup de projets de migration sont un échec (environ 80% selon Gartner) car les métiers remettent en question les chiffres. Et Cela parle à toutes les DSI.

Une migration BI ne se valide pas par simple comparaison tableaux de bord entre ancien et nouveau. Elle demande de mener une campagne exhaustive de validation métiers

  • Règles de calcul (formules, agrégations, hiérarchies)
  • Seuils d’écarts acceptables (tolérances business)
  • Périodes de référence (cohérence temporelle)
  • Données de contrôle (échantillons critiques)
  • Profils statistiques (min/max, distributions, nullité)
  • Intégrité référentielle (clés étrangères, liens inter-tableaux)

On n’est pas dans l’esthétique Data Viz mais dans la confiance dans les chiffres sur lesquels les métiers vont s’appuyer pour prendre des décisions.

La couche sémantique (glossaire métier, data catalog avec lignage KPI), la documentation des indicateurs et les tests parallèles entre ancien et nouveau sont des critères décisifs de succès. C’est ici que se joue la différence entre une migration subie et une modernisation réellement utile.

Étape 8 : Enfin, décommissionner réellement !

Cette dernière étape est essentielle pour optimiser le ROI. Concrètement, il s’agit de désactiver tous les rapports remplacés, archiver ce qui doit l’être (exigences règlementaires ou métiers), fermer les dépendances techniques devenues inutiles, refaire une passe sur les licences et maintenance associés et mettre à jour la documentation. En clair, c’est le grand ménage !

À lire sur le sujet

  • De Power BI à data products, l’architecture BI temps réel de 2026
De Power BI à data products, l’architecture BI temps réel de 2026
  • Architecture data mesh & data catalog : la stratégie gagnante
Architecture data mesh & data catalog : la stratégie gagnante

Pilotage temps réel : pourquoi le streaming est le must-have de la BI en 2026

Paris, le 4 mars 2026
Auteurs : Luc Doladille et Emmanuelle Parnois

Le décisionnel « dans le rétroviseur » a fait son temps. Dans la plupart des organisations, la BI reste pourtant encore structurée autour d’extractions nocturnes, de chaînes ETL historiques et de dashboards générés à J+1 … alors que visualiser l’activité à postériori n’est plus suffisant. L’enjeu aujourd’hui est de rapprocher donnée, décision et action. Et c’est justement cela que le streaming apporte au SI décisionnel. On ne peut pas remettre au lendemain une fraude, une rupture de stock, une chute de marge ou problème logistique, le signal doit être envoyé dans les flux métiers au moment où il est exploitable. Tous les éditeurs de data streaming comme ceux de plateformes d’analytics agentiques partagent cette même vérité : l’IA s’alimente d’un contexte vivant, de données fraîches, traçables et gouvernées.

Terminé le batch ?

Pas tout à fait ! Le batch reste incontournables pour les usages réglementaires, les consolidations financières, les traitements historiques lourds ou les analyses peu sensibles à la latence. En revanche, il ne peut plus être seul moteur de pilotage de l’entreprise. Lorsqu’une décision métier dépend d’un événement survenu il y a quelques secondes ou quelques minutes, la fraîcheur de donnée est une variable métier essentielle pas un simple composant d’architecture data. Chez Smartpoint, spécialiste 100% Data IA, nous accompagnons nos clients depuis 20 ans dans l’évolution de leur plateforme data et nous constatons clairement un virage vers une BI streaming-first. Le flux temps réel devient un élément natif de l’architecture BI plutôt qu’un dispositif exotique réservé aux besoins les plus avancés.

Techniquement, cela repose sur la capture de l’événement à la source, via des patterns de type CDC (change data capture), des plateformes d’event streaming comme Kafka et des moteurs de traitement capables de travailler au temps de l’événement plutôt qu’au temps d’arrivée. Kafka sert désormais de plateforme d’event streaming pour alimenter des pipelines temps réel et des usages analytiques critiques. En parallèle, Apache Flink (ainsi que Structured Streaming dans l’écosystème Spark) permettent d’industrialiser un traitement continu. Flink met notamment en avant des garanties de cohérence de type exactly-once et une gestion native du temps d’événement. Le sujet n’est donc plus le simple transport de données mais la continuité du signal entre l’événement, son traitement et la décision métier.

Le schéma d’architecture le plus lisible reste souvent celui d’une architecture Kappa ou plus largement d’une approche stream-first : un même socle événementiel alimente les usages opérationnels et analytiques, au lieu de faire cohabiter des chaînes batch d’un côté et temps réel de l’autre. Le bénéfice ne tient pas seulement à la latence, il est aussi dans une urbanisation data plus simple, plus cohérente et plus durable.

Luc Doladille, Directeur Conseil, Smartpoint

De l’Operational Analytics au Live Steering

Le sujet n’est donc pas de produire un nouveau dashboard plus beau ou plus rapidement. Il s’agit de faire évoluer la BI vers l’Operational Analytics puis vers ce que l’on appelle le Live Steering, c’est à dire une donnée qui ne sert plus uniquement à constater mais à orienter directement l’exécution dans les outils métiers. Une anomalie de stock doit pouvoir déclencher une alerte d’approvisionnement, une dérive de marge doit remonter dans le CRM, un incident logistique doit influencer le TMS (transport management system) ou le WMS (Warehouse management system) et un écart dans un comportement client doit pouvoir ajuster en quasi temps réel une action marketing ou une priorité de traitement.

ThoughtSpot décrit d’ailleurs cette nouvelle génération d’analytics comme une capacité à combler l’écart entre le moment où l’on a besoin d’une réponse et celui où on l’obtient réellement, avec des insights de confiance délivrés en secondes plutôt qu’en jours.

Et cette évolution change le rôle du décisionnel. Certes, le pilotage mensuel ou hebdomadaire reste indispensable pour la trajectoire globale, la planification et l’arbitrage. Mais le pilotage temps réel, lui, gère l’exécution au quotidien. Il agit exactement là où se joue désormais la performance de l’entreprise et sa compétitivité : fraude, pricing dynamique, optimisation supply chain, disponibilité produit, qualité de service ou expérience client. La BI n’est plus une couche de restitution séparée du réel, elle devient un composant de l’action opérationnelle.

Alerting intelligent et Agentic BI, et le signal devient action

Chez Smartpoint, nos experts Data et IA recommandent l’Agentic BI. À ne pas confondre avec le chatbot analytique qui attend une question … l’agent analytics surveille en continu l’environnement de données, il détecte les variations significatives, il propose une décision et peut l’exécuter selon le niveau de gouvernance autorisé. ThoughtSpot de son côté définit l’Agentic Analytics comme une approche où les agents IA ne se contentent plus de faire remonter un insight. Ils surveillent les flux, détectent les anomalies, décident et agissent selon les objectifs métier. Et bien entendu, cette autonomie n’exclut pas la supervision humaine. Au contraire, elle la repositionne aux bons endroits, là où le risque ou l’impact la rendent indispensable.

Chez Smartpoint, nous avons structuré notre démarche autour d’un cycle très simple, inspiré de l’OODA Loop et appliqué à l’analytique temps réel : observer, analyser, décider, agir.

La fin du dashboard statique, on passe à des interfaces éphémères

Autre évolution structurante, le dashboard n’est plus forcément figé selon un formalisme prédéfini. Les nouvelles approche d’Agentic BI Dashboard promettent un monde où l’interface analytique est dynamique, éphémère et générée à la volée selon l’intention de l’utilisateur métier. En clair, au lieu de maintenir une usine de tableaux de bord statiques, on laisse un agent IA comprendre la question, aller chercher les bonnes sources, exécuter les traitements nécessaires, puis composer le rendu visuel adapté. Évidemment, ce n’est pas absolument pas la réalité au sein des DSI mais Qlik a déjà fait des annonces en ce sens avec Qlik Answers comme Tableau Next et ThoughtSpot.

Il faut aussi noter, dans cette tendance de fond, la montée en puissance du Model Context Protocol (MCP). Il ne remplacera ni la gouvernance, ni la modélisation, mais il standardise la connexion entre les applications IA, les sources de données et les outils. Présenté comme un protocole ouvert , le “port USB-C” de l’IA », il facilite l’accès à des systèmes externes sans multiplier les connecteurs spécifiques. Le MCP ne porte pas, à lui seul, la BI du futur. En revanche, c’est un accélérateur concret pour des interfaces analytiques conversationnelles capables d’interroger SQL, API, fichiers ou moteurs de calcul sans empiler des couches de code ad hoc.

En tant que pure player data IA, chez Smartpoint nous pensons qu’il faut prendre du recul face aux promesses de l’agentic analytics. Un agent analytique crédible n’a pas vocation à raisonner « au jugé » sur des calculs sensibles. Nos ingénieurs Data IA se concentrent au contraire sur l’exécution de code, par exemple en Python, pour fiabiliser les traitements et sécuriser les résultats, plutôt que de déléguer le raisonnement numérique au seul modèle. Sur des sujets aussi critiques que la marge, la fraude ou la performance commerciale, cette exigence méthodologique change tout côté DSI.

Quel système data pour un décisionnel temps réel ? Architecture et outils

Selon nos architectes Data IA, l’architecture BI temps réel s’organise autour de quatre couches.

1. Ingestion et transport d’événements

La première est celle de l’ingestion et du transport événementiel. Kafka reste la référence pour nos équipes Data IA avec tout son écosystème de connecteurs, de CDC et de patterns event-driven. Les plateformes managées sont de plus en plus fréquentes parce que les équipes veulent consacrer moins d’énergie à l’exploitation de clusters et davantage à la qualité, à la gouvernance et aux data products.

2. Traitement in-flight

La deuxième couche est celle du traitement in-flight. Flink, PyFlink, Spark Structured Streaming et les capacités temps réel de Databricks permettent de filtrer, enrichir, agréger et corréler les événements avant leur exposition analytique. C’est essentiel pour un SI décisionnel moderne qui ne se résume pas à sa vitesse mais aussi en sa capacité à combiner faible latence, tolérance aux pannes, gestion du temps d’événement et garanties de traitement cohérentes.

3. Serving layer analytique faible latence

La troisième couche est celle de la serving layer analytique faible latence. Sur ce terrain, ClickHouse et StarRocks s’imposent dans de nombreux scénarios de requêtes sub-secondes, de dashboards à forte concurrence et de workloads orientés agents. ClickHouse se positionne comme une base analytique open source pour le real-time analytics, tandis que StarRocks met en avant des requêtes multi-tables à latence sub-seconde et une capacité à servir des agents IA à forte concurrence (Voir comparatif dans les sources).

4. Plateformes unifiées cloud et data/AI

La quatrième couche est celle des plateformes unifiées cloud et data/AI. Microsoft Fabric pousse une logique de Real-Time Intelligence couvrant l’ingestion, la transformation, le stockage, l’analytique, la visualisation, l’IA et les actions temps réel. BigQuery est recommandé pour une analytique à grande échelle proche du temps réel. Snowflake, avec Unistore, est pour nos experts Data IA la solution lorsque l’on veut rapprocher le transactionnel et l’analytique dans une même plateforme. Globalement, tous les éditeurs convergent vers des architectures moins fragmentées où le décisionnel ne vit plus à plusieurs jours de distance de l’opérationnel !

De la corrélation à la causalité : pourquoi un agent seul ne suffit pas

Dans les secteurs régulés, il y a une problématique incontournable, celle de la validation.

Un bon agent de pilotage ne doit pas seulement corréler un signal et proposer une action. Il doit aussi pouvoir expliquer, sourcer, justifier et dans certains cas, se faire contredire. C’est là que les architectures multi-agents sont particulièrement adaptées avec un agent d’accès à la donnée et à la sémantique, un agent d’analyse ou de simulation, puis un agent de validation chargé de vérifier les seuils, les droits, les incohérences ou la nécessité d’une approbation humaine. L’enjeu est de rendre le pilotage automatisé certes, mais aussi auditable.

Une trajectoire de modernisation BI en 3 mois ?

En tant qu’expert en Data IA, nous prônons une approche incrémentale qui permet d’amorcer la trajectoire sans refaire le SI Décisionnel.

J1 à J30 : cadrer le data product temps réel

Identifier un cas d’usage où la fraîcheur de donnée a un impact business immédiat : fraude, stock, supply chain, pricing, relation client. Cartographier les sources, définir les KPI et les encoder dans une semantic layer gouvernée.

J31 à J60 : lancer le pilote streaming

Brancher un premier flux live, exposer un data product exploitable, mesurer la latence, la qualité, l’adoption et la capacité d’action dans le système cible. L’objectif n’est pas de faire du temps réel partout, mais de prouver la valeur sur un périmètre précis.

J61 à J90 : industrialiser l’alerting et préparer la sortie du legacy


Mettre en place des alertes intelligentes, les workflows d’escalade, l’observabilité des flux et les premières règles d’automatisation. Puis construire la roadmap de décomissionnement progressif des dashboards et des suites legacy qui génèrent plus de valeur.

En 2026, la BI n’est plus seulement un système de reporting. Elle devient une capacité de pilotage opérationnel, branchée sur le réel, nourrie par des flux continus, gouvernée par une couche sémantique stable et de plus en plus capable d’agir. Les organisations qui sauront passer d’une information stockée à une information vivante auront clairement une longueur d’avance avec moins de latence entre le signal, sa compréhension et la décision. Et, en matière de modernisation BI, c’est là qu’on arrête de piloter dans le rétroviseur !

Plus d’informations ? Besoins d’accompagnement ou de conseils ? Laissez-nous un message, nos experts Data-IA reviennent vers vous dans la journée.

Pour aller plus loin :

De Power BI à data products, l’architecture BI temps réel de 2026

Paris, le 25 février 2026 – Auteurs : Luc Doladille, Frédéric Legrand et Emmanuelle Parnois

Temps de lecture : 16 min

La BI s’est longtemps résumée à un choix d’outils : sélection de solutions de dataviz (Power BI, Tableau, Qlik) pour générer des dashboards. Pourtant, l’outil n’est pas le problème de fond, le véritable défi est l’urbanisation du SI décisionnel.

La BI doit se transformer pour devenir une architecture de services de données capable de délivrer des indicateurs fiables, traçables et surtout interopérables avec les nouveaux paradigmes de l’IA (RAG, architectures orientées agents, copilotes métiers).

Pour les DSI et CDO, ce virage est critique. Tant que la BI demeure une simple couche de restitution déconnectée d’une gouvernance forte, les pathologies classiques persistent :

  • Désalignement sémantique et KPI divergents
  • Shadow BI persistant avec l’Excel de « réassurance »
  • Surcharge cognitive due à l’empilement de reportings silotés

Chez Smartpoint, nos experts Data & IA observent que la valeur ne réside plus dans le dashboard, mais dans la capacité à orchestrer des Data Products via via une couche sémantique transverse et un Metrics Layer unifié.

Pourquoi les dashboards ont atteint leurs limites ?

Les dashboards BI classiques saturent en indicateurs

Le dashboard reste un outil indispensable. Le vrai problème ? C’est la place centrale qu’il occupe aujourd’hui dans la BI alors qu’il n’est « que » la couche visible de l’architecture sous jaccente.

Avec le temps, les écrans se sont empilés : trop de KPI, vues multiples, filtres complexes. La lisibilité est en chute libre et les décisions approximatives. La BI dérive inexorablement vers un enchevêtrement de reportings, loin d’une plateforme de pilotage agile basée sur des données de confiance.

Cette saturation cache un mal plus profond. Les demandes incessantes de nouveaux indicateurs sont le symptôme d’une dette BI avec des metrics non fiables ou mal alignées sur les besoins métiers.​

Le syndrome de l’Excel de la « vérification finale »

Lorsque l’utilisateur final extrait les données de son dashboard pour les retraiter localeur dans un tableur Excel, ce n’est pas par habitude … c’est par défiance envers le référentiel. Cette réassurance manuelle est symptomatique de l’échec d’une stratégie BI purement visuelle qui a mis de côté la fiabilité de sa couche sémantique.

Chez Smartpoint, nous analysons ce phénomène comme une rupture de la lignée de données (Data Lineage). Si le métier ressent le besoin de vérifier le chiffre, c’est que la BI n’a pas réussi à imposer une Single Source of Truth (SSOT) et les conséquences ne sont pas neutres :

  • Désynchronisation décisionnelle : Chaque tableur devient un silo de données avec ses propres règles de calcul maison créant une entropie informationnelle majeure.
  • Invisibilité de la donnée : La logique métier s’échappe du SI pour se concentrer dans des macros Excel opaques rendant toute maintenance ou évolution impossible.
  • Risque de conformité et de sécurité : La multiplication de ces fichiers partagés fragilise la gouvernance et expose l’entreprise à des fuites de données sensibles.

Pour éradiquer ce phénomène, la réponse n’est pas de supprimer Excel mais de recentraliser l’intelligence métier au sein d’une architecture basée sur des Data Products. En déplaçant la logique de calcul du dashboard vers un Metrics Layer unifié, on garantit que le chiffre affiché est le même, quel que soit le point de consommation (Power BI, interface métier ou agent IA).

Nos experts Data IA accompagnent cette transition au sein des organisations pour restaurer la confiance et garantir que le pilotage de l’entreprise repose bien sur une donnée certifiée et non sur des intuitions recalculées en urgence.

Une BI trop rétrospective, pas temps réel

Conçus pour ingérer l’historique, les dashboards sont parfaits en post-mortem … mais les directions métiers attendent des insights immédiats (alertes stocks, fraude, marge dynamique, pilotage logistique fin., etc.).

Le batch processing reste pertinent pour de nombreux usages consolidés mais il ne suffit plus à lui seul pour les besoins de pilotage temps réel dans un contexte de volumes massifs de données. Il est nécessaire de mettre en place une ingestion continue, du streaming via Kafka ainsi que du monitoring et de l’alerting multi-canaux. Une architecture décisionnelle moderne intègre donc un historique fiable et une réactivité temps réel avec des objectifs de fraîcheur adaptés aux cas d’usage (quasi temps réel pour la fraude, consolidation différée pour la finance, etc.).

Le dashboard est devenu le symptôme d’une obésité informationnelle. La multiplication des tableaux de bord révèle surtout une difficulté à hiérarchiser l’information. Cette dérive transforme le SI décisionnel en un labyrinthe de reportings silotés où la lisibilité est sacrifiée au profit de l’exhaustivité. Pour les directions IT, cette dette BI se traduit par une maintenance croissante sans création de valeur proportionnelle.

L’IA révèle les limites des dashboards

La BI augmentée et les agents IA bouleversent tout. Désormais, les queries en langage naturel deviennent la norme, tout comme les explications automatisées de KPI, les comparaisons instantanées ou les détections d’écarts. À titre d’exemples, Microsoft Fabric Copilot génère des synthèses automatiques, ThoughtSpot sort du lot en search IA, tandis que Sisense (encore peu présent en France mais à suivre de près !) déploie des agents autonomes.​

L’IA exploite les données disponibles mais elle ne corrige ni leur qualité ni leurs incohérences. Sans métriques versionnées ni sémantique stable, des dashboards divergents produisent des réponses rapides… mais complètement incohérentes. Et La crise de confiance s’installe alors irrémédiablement.

Luc Doladille, Directeur Conseil, Smartpoint

L’IA n’efface pas les failles architecturales sous-jacentes. Au contraire, elle les amplifie. Et pour performer, elle exige une BI mature : data products, metrics layer headless et pilotage temps réel intégré.

L’IA ne crée pas la donnée, elle l’orchestre. Sans métriques versionnées ni sémantique immuable, déployer des agents autonomes revient à automatiser le chaos. Nos experts Data IA insistent sur ce point : pour performer, l’IA exige une BI mature reposant sur des Data Products certifiés et un Metrics Layer headless, garantissant l’alignement entre l’insight généré et la réalité business.

Comment passer du reporting à une véritable architecture décisionnelle ?

De la logique dashboard à la production de la vérité métier

Migrer vers une architecture décisionnelle nécessite de s’affranchir des débats outilocentrés pour se concentrer sur l’intégrité sémantique. Chez Smartpoint, nous considérons que le dashboard ne doit plus être une destination finale en soi mais un simple point de consommation parmi d’autres (API, agents IA, apps). Cette bascule redéfinit la modernisation du SI Data, on ne livre plus un écran, on garantit une métrique métier immuable.

Structurer la BI autour de data products analytics

Pour briser la logique de « reporting projet par projet », l’approche par Data Products est pour nous un levier de scalabilité majeur. Nos experts Data IA préconisent de concevoir le système autour d’usages concrets (marge dynamique, performance supply chain, revenus, etc.) plutôt que sur des pipelines isolés. Chaque Data Product embarque :

  • Un périmètre métier certifié et une modélisation en étoile (faits/dimensions)
  • Une documentation des règles de calcul et des KPIs exposés
  • Des contrôles de qualité automatisés et un ownership métier/IT identifié

Chez Smartpoint, nous sommes convaincus par l’approche Architecture-first plutôt que Outil-first. Cela permet d’éradiquer durablement les datamarts obsolètes au profit d’une intelligence partagée.

Faire le choix d’un pilotage temps réel avec une approche streaming-first

Si tous les usages ne nécessitent pas un traitement instantané, certains domaines liés par exemple à la fraude, aux stocks ou à l’expérience client exigent une réactivité forte que le Batch-only ne peut pas fournir. L’architecture décisionnelle moderne est hybride, c’est la somme de flux batch pour le consolidé et des flux continus via Kafka (ou solutions équivalentes) pour la criticité temporelle. Chez Smartpoint, nous concevons des plateformes data pour exposer la donnée via Snowflake, Microsoft Fabric ou Databricks, garantissant une fraîcheur de donnée optimale pour le monitoring et l’alerting IA sans briser la cohérence des KPIs.

Converger vers la logique headless BI

Le Headless BI est une véritable rupture technologique qui libère enfin les DSI du carcan des solutions monolithiques ! Nos experts Data IA recommandent cette approche pour découpler la couche sémantique (le Metrics Layer) de la couche de restitution (Power BI, Tableau, Excel ou interfaces IA). En transformant les métriques en actifs architecturaux versionnés, gouvernés et réutilisables, on garantit une cohérence parfaite quel que soit le canal de consommation des données.

Chez Smartpoint, nous délivrons des architectures data qui ont pour intérêts d’offrir :

  • Agnosticité technologique : Réduction de la dépendance éditeur (vendor lock-in)
  • Fluidité des migrations : Transition pilotée des systèmes legacy (Cognos, Business Objects) vers des stacks data modernes sans perte de logique métier
  • Interopérabilité multi-outils : Une règle de calcul unique pour Excel, vos dashboards et vos portails applicatifs
  • Compatibilité IA native : Fourniture d’un contexte sémantique structuré indispensable aux agents autonomes et au RAG
  • Résorption de la dette BI : Refonte du moteur décisionnel pour une maintenance simplifiée et une scalabilité accrue

L’objectif est moderniser le cœur du réacteur décisionnel pour en faire un levier de performance durable et un socle prêt pour l’IA de demain.

Trajectoire de modernisation, du reporting à l’architecture décisionnelle

La modernisation de votre BI ne passe pas par un simple lift-and-shift technologique. Nos experts Data IA recommandent une approche incrémentale et pilotable, centrée sur la résorption de la dette technique et l’agilité métier.

1. Inventaire des data assets et cartographie de la dette BI

Cette première phase d’audit couvre l’ensemble de la chaîne de valeur décisionnelle :

  • Typologie des assets : Identification des dashboards actifs vs. dormants, des datamarts redondants et des pipelines ETL/ELT critiques.
  • Gouvernance et sémantique : Cartographie des couches sémantiques hétérogènes (BO, Cognos, Power BI) et des KPI critiques avec leurs différentes variantes.
  • Flux et dépendances : Analyse des systèmes d’ingestion (batch vs temps réel) et des adhérences métiers/techniques.

Cet inventaire permet d’objectiver la dette BI en mettant en lumière les doublons, les coûts de run invisibles, les actifs intouchables non documentés et les risques de rupture de continuité de service. Chez Smartpoint, nous considérons que cette visibilité est un préalable indispensable à toute stratégie de désendettement technologique et de modernisation de votre plateforme BI.

2. Construire une Metrics Layer unifiée et versionnée

La seconde étape consiste à extraire l’intelligence métier des outils de restitution pour la centraliser dans une metrics layer souveraine. Tout l’enjeu est de passer à ce stade d’une logique de calcul pas toujours très claire à une vraie discipline d’architecture data rigoureuse.

Une metrics layer moderne, telle que conçue par nos experts Data IA, est :

  • Documentée et testée pour garantir la fiabilité intrinsèque de la donnée
  • Versionnée et traçable en s’appuyant sur des approches déclaratives (YAML, dbt, modèles sémantiques versionnés) selon la stack data cible (Snowflake, Fabric, Databricks)
  • Et alignée pour assurer une cohérence absolue entre les règles métier et leur exécution technique.

Chez Smartpoint, nous pensons que l’outil technologique utilisé est secondaire. C’est la discipline imposée par l’architecture Data et la centralisation des métriques qui garantissent la pérennité du SI Décisionnel et sa capacité à supporter les futurs cas d’usage de l’IA.

3. Industrialiser le SI décisionnel avec les Data Products et l’IA-Readiness

La finalité d’une bonne trajectoire de modernisation ne consiste pas à livrer un projet mais à établir un mode de production industriel. Le Data Product est le noyau où chaque domaine métier devient responsable de ses actifs informationnels, exposés via des interfaces normalisées. Cette approche transforme le SI décisionnel en une plateforme de services data prête à alimenter les architectures de Generative BI.

Et pour que cela soit efficient, la plateforme doit répondre à 3 impératifs :

  • L’interopérabilité sémantique : Garantir que le Metrics Layer centralisé alimente indifféremment les LLM via des techniques de RAG (Retrieval-Augmented Generation) et les outils de dataviz traditionnels éliminant ainsi toute dissonance cognitive entre l’IA et l’humain.
  • Le cycle de vie DevOps appliqué à la Data : Automatiser les tests de régression sur les KPIs et le déploiement continu (CI/CD) des modèles de données pour réduire le Time-to-Market des nouveaux indicateurs. À lire sur ce sujet « Voici venu le temps des DataOps« .
  • Le pilotage par la valeur (FinOps & Data Usage) : Monitorer l’adoption réelle des produits de données pour décommissionner les actifs obsolètes et optimiser la consommation des ressources cloud (Snowflake, Fabric ou Databricks).

4. Consolider l’architecture par une gouvernance industrialisée

La dernière étape de la trajectoire, et souvent sous-estimée, consiste à industrialiser la gouvernance pour transformer le SI Data en un environnement auto-porteur et auditable. Chez Smartpoint, nous considérons que la gouvernance des données ne doit plus être un goulot d’étranglement, mais une infrastructure invisible qui sécurise chaque interaction avec la donnée.

Pour garantir cette pérennité, nos experts en gouvernance des données déploient des cadres de gouvernance qui s’appuient sur :

  • Une sécurité granulaire et dynamique : Mise en œuvre de politiques de RLS / CLS (Row-Level Security / Column-Level Security) et gestion fine des rôles (RBAC) pour garantir que l’accès à la donnée soit strictement proportionné à l’usage métier.
  • Une traçabilité et observabilité bout-en-bout : Maîtrise du lineage fonctionnel et technique pour cartographier le parcours de la donnée, du système source jusqu’à l’insight IA, couplée à un monitoring de fraîcheur en temps réel.
  • L’auditabilité et l’observabilité des pipelines : Automatisation de la surveillance des flux pour détecter les dérives (data drift) et garantir l’auditabilité permanente des usages, condition sine qua non pour l’IA régulée (préparation Data Act).

Le rôle de la sémantique et de la couche métrique

La couche sémantique constitue probablement la brique la plus stratégique (et la plus souvent négligée) de l’urbanisation des données. Elle est le liant entre l’infrastructure technique (ERP, CRM, WMS, logs) et les concepts métiers manipulés au quotidien par les directions opérationnelles.

Traduire la complexité en langage métier actionnable

La couche sémantique ne fait pas que stocker les données, elle traduit une complexité technique brute en objets décisionnels utilisables et gouvernables. Qu’il s’agisse de définir une marge nette, un taux de churn ou un retard de livraison, cette couche garantit que chaque acteur de l’entreprise parle la même langue. Sans ce socle, chaque outil de dataviz recrée sa propre logique et on aboutit à de multiples indicateurs divergents où personne n’est d’accord sur la réalité des chiffres…

Standardiser via un dictionnaire partagé et des règles d’agrégation

Pour nos experts Data IA, la sémantique doit évoluer d’un simple dictionnaire de données passif à un véritable système d’exécution de la cohérence. Et cela demande une rigueur architecturale qui apporte une valeur ajoutée immédiate grâce à :

  • L’explicabilité des règles d’agrégation : Garantir que les dimensions (temps, géographie, Business Unit) sont appliquées de manière immuable sur l’ensemble de la stack.
  • La gouvernance du changement et versioning : Assurer la traçabilité des évolutions de calcul pour maintenir un data lineage impeccable.
  • L’unification des environnements hybrides : Réconcilier, au sein d’une même vérité, la BI legacy (Cognos, SAP Business Objects), les plateformes cloud modernes (Snowflake, Fabric) et les nouveaux usages liés à l’IA générative.

Chez Smartpoint, nous sommes convaincus que cette standardisation répond à l’instabilité sémantique qui empêche le déploiement des agents autonomes.

Décommissionnement ou migration Cognos, Business Objects, Talend : penser système, pas brique

Le remplacement d’une brique historique telle que Cognos, Business Objects ou Talend est un cas d’école de la dette BI ! L’erreur est de moderniser l’outil en surface sans repenser l’architecture data globale, ce qui ne fait que déplacer les problèmes vers une nouvelle technologie. Pour nos experts Data IA, cela va au-delà de la simple migration technique.

Tout l’enjeu est de découpler définitivement la logique métier des outils de restitution pour préparer nativement la compatibilité avec les futurs usages de l’IA. C’est précisément là que l’approche Architecture-first fait toute la différence : au lieu de transférer une dette technologique vers le cloud, nous mettons en place les processus nécessaires pour la résorber progressivement. En adoptant cette vision systémique, la modernisation des systèmes décisionnels permet d’activer une transformation durable plutôt qu’un éternel recommencement technologique.

La BI de 2026 est un système de pilotage

Le temps de l’accumulation de Dashboards est terminé. La priorité est d’adopter une architecture Data orientée services et dans l’intégrité de votre couche sémantique. Tout l’enjeu est de briser le cycle de la dette technique pour instaurer une culture de la donnée certifiée, fluide et nativement compatible avec les exigences de l’IA.

Nos experts Data IA vous accompagnent dans cette trajectoire, de l’audit de votre patrimoine existant à l’implémentation de Data Products scalables et de Metrics Layers souveraines. Ne laissez plus l’obsolescence de vos outils legacy freiner le business.

Prêt à transformer votre SI Décisionnel en moteur d’innovation ? Nos experts Data IA vous accompagnent dans la modernisation de votre architecture data :

  • Audit 360° de votre dette BI : Cartographie de vos assets, identification des silos et évaluation des coûts de run invisibles.
  • Design d’architecture IA-Ready : Définition de votre trajectoire vers le Headless BI et le streaming-first.
  • Migration sécurisée de vos solutions legacy : Transition pilotée de vos environnements Cognos, Business Objects ou Talend vers les standards de 2026.

Contactez nos experts pour un premier échange.

Pour aller plus loin :

Vos questions, nos réponses :

Pourquoi les dashboards BI son remis en cause 2026 ?

Parce qu’ils restent souvent centrés sur la restitution et non sur la cohérence des métriques. Sans couche sémantique unifiée ni metrics layer, les dashboards multiplient les KPI divergents et alimentent la shadow BI.

Qu’est-ce qu’une architecture décisionnelle BI moderne ?

Une architecture décisionnelle est un système structuré qui combine plateforme data, orchestration, couche sémantique, metrics layer et canaux de consommation (BI, API, IA) pour produire une vérité métier fiable et gouvernée.

Qu’est-ce qu’une metrics layer et à quoi ça sert ?

Une metrics layer est une couche métrique centralisée qui standardise les définitions de KPI (chiffre d’affaires, marge, churn, stock, etc.). Elle permet de partager les mêmes règles de calcul entre les outils BI, les exports Excel, les applications métiers et les usages IA.

Pourquoi la couche sémantique est-elle essentielle dans la modernisation BI ?

La couche sémantique traduit les données techniques (ERP, CRM, WMS, logs) en concepts métier exploitables. Elle garantit que les indicateurs sont compris et calculés de façon homogène, ce qui est indispensable pour réduire la dette BI et fiabiliser le pilotage.

Qu’est-ce que le headless BI ?

Le headless BI consiste à découpler la logique métier (couche sémantique et metrics layer) de la couche de restitution (dashboards, Excel, portails, agents IA). Cette approche réduit la dépendance aux outils, facilite les migrations BI et améliore l’interopérabilité.

Comment passer d’un reporting classique à une architecture décisionnelle moderne ?

La trajectoire la plus efficace est incrémentale : inventaire des data assets, cartographie de la dette BI, unification des KPI critiques via une metrics layer, structuration en data products analytics, puis industrialisation de la gouvernance (RLS/CLS, lineage, observabilité).

Faut-il abandonner le batch pour passer au temps réel ?

Toujours pas ! Une architecture décisionnelle moderne combine batch et streaming. Le batch reste pertinent pour les usages consolidés, tandis que le streaming-first répond aux besoins de pilotage temps réel (fraude, stock, alerting, expérience client).

Pourquoi la modernisation BI est-elle un prérequis pour l’IA ?

Parce que les copilotes analytiques, la BI augmentée et les agents IA s’appuient sur des métriques stables et une sémantique fiable. Si la plateforme décisionnelle est fragmentée, l’IA accélère l’accès à des données incohérentes au lieu d’améliorer la décision.

Modernisation de la BI et du SI Data : réduire la dette de la plateforme décisionnelle pour alimenter l’IA

Auteurs : Luc Doladille et Emmanuelle Parnois

Votre plateforme BI est le résultat d’un empilements d’outils, de couches sémantiques, de différents usages métiers…. Très rares sont les entreprises qui peuvent s’appuyer sur une plateforme décisionnelle unifiée. Derrière ce constat se cache une dette technique bien souvent considérable qui freine les nouveaux usages mais aussi l’intégration des nouvelles technologies : rapports redondants, métriques divergentes, modèles sémantiques incohérents, licences sous-utilisées, environnements legacy toujours actifs. Sans compter le coût de la dette en licences, en maintenance, en perte de confiances dans les données, etc.

La migration Cognos, la migration Business Objects vers Power BI ou encore le remplacement Talend (pour ce citer qu’eux) sont des problématiques récurrentes. Et ces chantiers d’inscrivent dans une volonté plus globale de modernisation de la plateforme décisionnelle et de rationalisation des outils BI.

Rationaliser la BI, ce n’est pas remplacer un outil par un autre. Il s’agit souvent de redéfinir une architecture cible cohérente, capable d’évoluer vers une plateforme décisionnelle cloud maîtrisée. Moderniser le SI Data, c’est également un prérequi pour intégrer et supporter l’IA à l’échelle. Les copilotes analytiques, la BI augmentée, les agents IA et les architectures RAG reposent tous sur une couche décisionnelle fiable. Intégérer l’IA sur des métriques instables ou sur une plateforme décisionnelle fragmentée ne fait qu’amplifier les incohérences existantes.

Moderniser la BI, ce n’est pas seulement moderniser un outil. C’est reconstruire la couche de confiance indispensable pour alimenter l’IA en données fiables, traçables et maîtrisées.

La dette BI freine la modernisation du SI Data

L’empilement des plateformes BI legacy

Chez Smartpoint, il n’est pas rare que nous soyons amené à intervenir sur des environnements décisionnels dont certaines briques datent des années 2000 ! IBM Cognos, SAP Business Objects, MicroStrategy sont encore très présents pour le reporting financier, réglementaire ou opérationnel et dans la plupart des cas bien intégrés avec les ERP.

Ces solutions sont souvent maintenus pour les rapports critiques mais les nouveaux usages sont développés avec avec du PowerBI, du Qlik ou encore du Tableau. Certes, des projets de migration Cognos ou de migration Business Objects ont souvent été lancés mais rarement menés à terme pour de multiples raisons : des milliers de rapports peu documentés, des dépendances cachées, le modèle sémantique, l’adoption non au rendez-vous, des datamarts fragiles, etc. Il est d’ailleurs indispensable de se faire accompagner par un spécialiste Data comme Smartpoint, capable de recréer ou de refondre les univers BO et les couches sémantiques Cognos, de sécuriser les règles de calcul et les définitions de KPI et de garantir une migration BI fidèle, gouvernée et industrialisable.

Quoi qu’il en soit, nombreux sont les SI Data qui composent avec le legacy et des outils BI modernes avec pour conséquences : double maintenance, double modèle sémantique, double ressources, double gouvernance. Les indicateurs financiers peuvent être produits dans Cognos, tandis que les indicateurs opérationnels le sont dans Power BI. Les mêmes métriques sont définies différemment selon les environnements…. et la dette technique BI s’installe.

À cela s’ajoutent les outils ETL et de data integration ! Talend, Informatica, SSIS, ODI, DataStage ou encore SAP Data Services sont encore très présents dans les DSI. Dans ce cas précis, la modernisation BI ne se résume pas au remplacement de tel ou tel ETL mais à recomposer une chaîne data cloud/hybride (ingestion, CDC, ELT, orchestration, qualité, observabilité).

Et la dette BI fait son nid …

Cette architecture data fragmentée que nous observons régulièrement chez nos clients cache une dette bien réelle. Elle ne se voit pas toujours au quotidien, mais elle se rappelle au bon souvenir de la DSI à chaque évolution de périmètre, à chaque demande métier pressante ou lors de chaque clôture financière tendue. Elle finit par dicter son propre rythme à l’entreprise : lenteur opérationnelle, incohérences analytiques, arbitrages subis et, plus grave encore, une érosion lente mais certaine de la confiance dans les données. Pour nos experts Data IA, cette dette est le premier obstacle à franchir avant d’envisager un déploiement industriel de l’IA.

1. La prolifération des datamarts en silos

Les datamarts sont toujours nés d’une bonne intention : gagner en agilité en isolant un domaine métier ou répondre à un besoin urgent sans avoir à refondre le Data Warehouse historique. Au fur et à mesure des années et des besoins, ces silos se sont multipliés … jusqu’à recouvrir des périmètres quasi identiques. Les mêmes données sources (ERP, CRM, RH) se retrouvent chargées et transformées plusieurs fois avec des règles de gestion divergentes, notamment sur la temporalité des traitements. Les écarts se creusent inévitablement et au moment de prendre une décision stratégique en Comex, la DSI se retrouve face à un choix cornélien entre plusieurs versions de la réalité. Illusoire pilotage de l’entreprise par la donnée !

2. Le conflit des couches sémantiques entre BI Legacy vs BI Moderne

La dette décisionnelle n’est pas cantonnée dans le stockage, elle s’est enracinée dans la logique métier. Dans les environnements BI legacy, les univers Business Objects ou les frameworks Cognos encapsulent des années d’intelligence métier (définitions des KPI, hiérarchies complexes, règles). Lorsque les nouveaux usages basculent vers des outils de Dataviz moderne comme Power BI ou Qlik, une seconde couche sémantique est souvent créée ex nihilo sans accès complet aux règles historiques. Chez Smartpoint, nous alertons régulièrement nos clients sur ce risque de double maintenance… Deux logiques de calcul pour un même indicateur génèrent inexorablement des divergences. La « dette BI » devient source de crise de crédibilité pour la DSI.

3. L’explosion de la Shadow BI et du « Excel for ever »

Dans une organisation quelle qu’elle soit, la Shadow BI n’est pas le fruit du hasard ni cantonnée à des geeks. C’est la conséquence directe d’une plateforme BI officielle qui ne répond pas aux attendus. Quand le SI décisionnel ne délivre pas la granularité ou la fraîcheur attendue, les métiers prennent le contrôle par pragmatisme. Et le shadow BI est polymorphe : export massif, fichier Excel partagé jusqu’à l’industrialisation clandestine à base de macros et de requêtes personnelles. Pour la DSI, la prix à payer est lourd entre risque majeur de fuite de données et l’énergie colossale à déployer pour réconcilier les chiffres produits . Paradoxalement, l’introduction d’outils BI modernes sans rationalisation peut accélérer la production de rapports isolés … sans jamais réduire la dette de fond.

4. Une orchestration éclatée et une fragilité opérationnelle

Lorsque les briques technologiques s’accumulent, l’orchestration des flux suit la même trajectoire erratique. On retrouve souvent un ordonnanceur historique pour les batchs mainframe, un scheduler ETL pour les flux data classiques et des outils natifs cloud pour la nouvelle plateforme Data. Chaque brique fonctionne individuellement mais l’ensemble souffre du manque de synchronisation globale. Là encore, nos experts Data se retrouvent à constater les dégâts entre dépendances implicites, incidents « fantômes » liés à des retards amont et l’incapacité à garantir le lineage de la donnée. Cette dette de traitement rend le système Data extrêmement fragile et incapable de répondre à la question fondamentale de toute gouvernance des données : « Qu’est-ce qui a produit ce chiffre, et quand ? ».

5. Les coûts invisibles du « Run » et le piège du sur-licensing

La dette BI est une dette économique directe que le FinOps tente de réguler. Une plateforme data fragmentée génère des coûts de sur-licensing redondants, avec des modules historiques qui sont conservés « au cas où » tout en finançant de nouveaux outils SaaS. Le coût du « Run » explose : exploitation multiple, environnements dupliqués et mobilisation de compétences pénuriques sur des technologies vieillissantes. À cela s’ajoute une maintenance lourde pour corriger des ruptures de flux. Le comble ultime pour la DSI : plus l’entreprise produit de rapports, plus elle finance des actifs redondants et plus il devient compliqué de rationaliser le SI Data sans risquer de casser un usage métier critique mais non documenté. Le budget innovation de la DSI est littéralement

Le cas TALEND par Luc Doladille, Directeur Conseil Data IA

Modernisation plateforme Data ? Commencer par réduire la dette BI progressivement

Ce n’est pas le temps du « Grand Soir » mais plutôt celui des « Petits matins blêmes » ! Grande est la tentation de la migration Big Band face à l’ampleur de la dette BI / Data mais ce n’est malheureusement pas réaliste hormis pour des PME ou ETI faiblement outillées. Chez Smartpoint, nous privilégions une approche sur-mesure incrémentale. Rationaliser le SI décisionnel, ce n’est pas changer des outils par d’autres. Il s’agit de reconstruire une architecture Data capable de supporter l’industrialisation de l’IA tout en garantissant la continuité des opérations métiers. Nos experts Data IA ont modélisé une trajectoire de modernisation qui repose sur quatre étapes clés pour transformer votre legacy Data en une plateforme agile. À lire sur ce sujet « IA et architecture data moderne : Révolutionnez la gestion et l’analyse de vos données.« 

1. L’unification par la Metrics Layer pour restaurer la vérité

La première étape de notre méthodologie consiste à extraire l’intelligence métier des outils pour la centraliser dans une Metrics Layer unifiée. Plutôt que de laisser des règles de calcul critiques éparpillées entre les Univers BO historiques et un modèle Power BI plus récent, nous recommandons la mise en œuvre d’une couche sémantique transverse. Cette approche permet de garantir que la définition d’un « Chiffre d’Affaires » ou d’une « Marge Opérationnelle » est identique que la donnée soit consommée par un contrôleur de gestion sur Excel ou par un agent IA en architecture RAG. En créant ce référentiel unique, nous supprimons de fait la double maintenance et les divergences qui alimentent la Shadow BI. C’est ici que se joue la reconstruction de la confiance envers le SI Data.

2. Adopter une approche par Data Products Analytics

Pour briser les silos décrits précédemment, nos consultants Data accompagnent les directions IT pour passer d’une logique de flux à une logique de Data Products Analytics. Chaque domaine métier (RH, Finance, Supply Chain) devient propriétaire de ses données, conçues comme des produits finis, documentés et gouvernés. En structurant le SI autour de data products plutôt que des pipelines monolithiques, la gouvernance de données est facilitée et permet une scalabilité réelle. Cette modularité est indispensable pour intégrer les nouvelles technologies sans avoir à re-concevoir l’ensemble de la chaîne à chaque évolution. C’est la fin de l’effet domino où une modification dans l’ERP source faisait s’écrouler l’ensemble du reporting décisionnel.

3. La migration progressive où le décommissionnement intelligent de votre SI DATA

Une migration Business Objects ou un remplacement Talend ne se gèrent pas comme un simple projet IT. Notre stratégie de migration progressive repose sur l’identification des cas d’usage à haute valeur ajoutée. Nous isolons les briques critiques du legacy pour les basculer prioritairement vers la nouvelle cible Cloud ou hybride, tout en maintenant les processus stables sur l’ancienne infrastructure. Ce « strangler pattern » appliqué au décisionnel permet de réduire la dette technique par itérations, sans jamais mettre en péril la clôture mensuelle ou le reporting réglementaire. Cela permet également de libérer rapidement du budget de maintenance pour financer les nouveaux projets d’IA générative notamment.

4. Construire une architecture tool-agnostic pour pérenniser les investissements

La rationalisation pragmatique du SI Data implique de concevoir une architecture tool-agnostic. Le marché des outils Data évolue plus vite que les cycles de vie des entreprises… Nous nous attachons à concevoir des socles où la donnée et sa logique métier sont décorrélées de l’outil de restitution ou d’intégration. En privilégiant des standards ouverts et une interopérabilité maximale, nous aidons les entreprises à se prémunir du vendor lock-in. Cette agilité est le meilleur rempart contre la création d’une nouvelle dette technique à l’horizon 2030. Un SI Data performant doit pouvoir changer de moteur de visualisation ou de solution de stockage sans avoir à réécrire ses fondamentaux métiers.

Votre plateforme Data a besoin d’être modernisée pour intégrer les nouveaux usages (IA, ML, automatisation ?)

Ne laissez pas le poids de votre legacy BI étouffer vos ambitions d’innovation. Nos experts Data IA vous accompagnent pour auditer votre dette technique et tracer une feuille de route de modernisation du SI décisionnel pragmatique et incrémentale. Nous nous ferons un plaisir de vous accompagner vers une plateforme data moderne à la hauteur des nouveaux enjeux technologiques. Contact.

Pour aller plus loin :

Index égalité professionnelle femmes-hommes : 84/100

Smartpoint publie son Index de l’égalité professionnelle entre les femmes et les hommes au titre des données 2025, conformément aux dispositions réglementaires applicables. Pour l’année de référence, Smartpoint obtient la note globale de 84/100.

Le calcul de l’Index repose sur les indicateurs suivants : l’écart de rémunération, l’écart de taux d’augmentations individuelles, les augmentations au retour de congé maternité et la parité parmi les dix plus hautes rémunérations.

Pour Smartpoint, le détail des résultats est le suivant :

  • 34/40 sur l’écart de rémunération, écart constaté 5,9 % en faveur des hommes,
  • 35/35 sur l’écart de taux d’augmentations individuelles, écart constaté 18,9 % en faveur des femmes,
  • 15/15 sur les augmentations au retour de congé maternité
  • 0/10 sur la parité parmi les dix plus hautes rémunérations.

Dans une démarche d’amélioration continue, Smartpoint poursuit ses actions afin de renforcer l’égalité professionnelle, notamment sur les indicateurs présentant des marges de progression : l’écart de rémunération et la représentation parmi les dix plus hautes rémunérations. Des objectifs de progression seront définis et publiés conformément au cadre applicable.


Index égalité professionnelle Femmes-Hommes – Smartpoint (Données 2025)

À propos de Smartpoint
Smartpoint est un cabinet d’experts spécialisé en conseil et en ingénierie Data & IA. Depuis 2006, Smartpoint accompagne les entreprises dans la conception, la modernisation et l’industrialisation de leurs plateformes data et de leurs usages IA, avec une exigence forte sur la qualité, la sécurité, la gouvernance et l’exploitation dans la durée.

Contact : Emmanuelle Parnois, CMO, eparnois@smartpoint.fr

Smartpoint annonce son adhésion au Global Compact des Nations Unies

Paris, le 11 février 2026

Smartpoint, cabinet de conseil et d’ingénierie spécialisé en Data et IA, annonce aujourd’hui son adhésion au Global Compact des Nations Unies (Pacte mondial), cadre international de référence. Avec plus de 25 000 participants dans le Monde dont plus de 2 000 entreprises en France, cette initiative engage Smartpoint à intégrer les enjeux de durabilité et les exigences réglementaires européennes au cœur de son business model.

Un engagement RSE consolidé par la Médaille d’Or EcoVadis

L’adhésion au Global Compact vient consolider une trajectoire de responsabilité sociétale déjà récompensée par une médaille d’or EcoVadis. Cet engagement répond également aux exigences accrues de nos clients pour qui la solidité des engagements ESG de leurs partenaires est devenue un critère de sélection déterminant. Smartpoint s’inscrit dans cette dynamique de progrès constants, garantissant une maturité supérieure dans le pilotage des risques extra-financiers. Pour les directions IT et Achat, Smartpoint n’est pas seulement un prestataire technique, mais un maillon de confiance et une partie prenante engagée au sein de leur propre chaîne de valeur. Chez Smartpoint, cette excellence opérationnelle sécurise les projets de nos clients face aux nouveaux standards de conformité et aux attentes de transparence du marché.

De la CSRD à l’IA responsable, un alignement réglementaire structurant

Smartpoint intègre également les enjeux de durabilité et la conformité réglementaire européenne directement dans la conception et dans le delivery des projets Data & IA qui nous sont confier. Nos experts Data IA accompagnent notamment les DSI pour :

  • Sécuriser le reporting extra-financier : Utilisation de la matrice de correspondance entre la Communication sur le Progrès (CoP) et la directive CSRD pour structurer les données ESG.
  • Optimiser l’efficience énergétique : Application des principes environnementaux du Global Compact pour réduire l’empreinte carbone des infrastructures Cloud, appuyée par notre propre bilan carbone.
  • Garantir l’éthique algorithmique : Mise en conformité des modèles d’IA avec les principes de lutte contre la corruption et de respect des droits fondamentaux, assurant une gouvernance des données transparente.

L’expertise Data IA au service des dix principes du Pacte Mondial

En rejoignant le réseau français, Smartpoint accède à une communauté d’échange de bonnes pratiques de premier plan. Cet engagement permet à nos experts Data IA de traduire les dix principes de l’ONU en actions concrètes et auditables pour les Systèmes d’Information :

  • Droits de l’Homme et normes du travail : Chez Smartpoint, nous œuvrons pour un numérique inclusif en neutralisant les biais discriminatoires au sein des algorithmes et en garantissant le respect des standards internationaux du travail dans l’ensemble de nos processus d’ingénierie.
  • Environnement : Fort de son bilan carbone, Smartpoint applique les principes de précaution environnementale pour optimiser l’efficience énergétique des infrastructures Cloud. Nos experts Data IA s’appliquent à concevoir des pipelines de données les plus sobres possibles afin de réduire activement l’empreinte carbone numérique de nos clients.
  • Lutte contre la corruption et éthique numérique : Ce principe se traduit par une exigence de transparence algorithmique. Chez Smartpoint, nous développons des systèmes « boîte blanche » où l’explicabilité des modèles garantit l’intégrité des processus de décision automatisés, prévenant ainsi toute manipulation arbitraire ou « occulte ».

L’adhésion de Smartpoint au Global Compact des Nations Unies est la preuve de notre engagement en tant que partie prenante responsable au sein des écosystèmes de nos clients, » affirme Yazid Nechi, Président Directeur Général de Smartpoint. « Cela nous permet de garantir une ingénierie « Impact by Design » où l’excellence technologique de nos experts Data IA participe directement la transition écologique et sociale. »

À propos de Smartpoint

Smartpoint est un Cabinet de conseil et d’ingénierie spécialisée en Data et IA basé à Paris depuis 2006. Smartpoint accompagne les DSI et CDO dans la modernisation de leurs plateformes Data en utilisant les dernières innovations dont l’IA et l’automatisation avancée. Smartpoint accompagne les DSI et CDO dans le déploiement de solutions critiques. Nos experts Data IA s’engagent à concevoir et à mettre en oeuvre des solutions nativement éthiques, souveraines et les plus décarbonées possibles. En privilégiant des architectures moins énergivores, notamment face aux enjeux du Cloud, Smartpoint se postionne comme partie prenante de confiance pour bâtir un numérique d’excellence, responsable et durable.

Plateforme IA souveraine, opérer un RAG en production en toute confiance

Après une année consacrée aux expérimentations IA, nous constatons chez Smartpoint que la mise en production suscite de nouvelles préoccupations. De plus en plus de DSI (voire le Comex) se posent la question de la souveraineté des données. L’IA, ce n’est pas qu’une question de performance … mais aussi de territoire, de dépendance et de responsabilité.

Risques d’exposition des données, forte dépendance vis-à-vis des acteurs américains (vendor lock-in) et contexte géopolitique instable, tous les facteurs sont réunis. Le temps est venu de se poser la question de comment concevoir une plateforme IA souveraine capable d’opérer un RAG en production.

Mettre en production l’IA générative sans audit possible et avec des coûts non maîtrisés n’est pas une option viable.

« La souveraineté IA est liée au contrat d’exploitation : qui possède vos clés, où sont hébergés vos modèles et sous quelle juridiction tombent vos données » souligne Luc Doladille, Directeur conseil data & IA,

Pourquoi un RAG souverain ?

Le passage à l’IA agentique et le déploiement d’un copilote IA privé en entreprise soulèvent des vulnérabilités critiques que les solutions SaaS « boîte noire » ne peuvent pas couvrir. Pour une direction DSI, l’enjeu n’est pas d’accéder à un modèle performant mais de garantir la maîtrise du cycle de vie des données.

Le système doit être exploitable, auditable et gouvernable.

La souveraineté est le socle de confiance indispensable pour soutenir l’innovation. Opérer une architecture RAG souveraine permet de relier la puissance des LLM au patrimoine documentaire de l’entreprise, tout en garantissant un cadre d’hébergement et d’exploitation maîtrisé (cloud de confiance, exigences sécurité, conditions contractuelles). C’est cette maîtrise qui permet de construire une IA générative compatible avec les exigences RGPD et prépare celles de traçabilité, de documentation et de tenue de logs lorsque les cas d’usage relèvent des obligations de l’AI Act.

Enfin, une approche souveraine remet la DSI en capacité de piloter le TCO d’un RAG (coûts d’inférence, de réindexation, d’observabilité, d’exploitation) et d’offrir aux métiers un copilote privé fiable, mesuré, et sous contrôle.

Plateforme IA souveraine : de quoi parle-t-on ?

Pour nos experts Data IA, la souveraineté se traduit par un contrat d’exploitation vérifiable.

Une plateforme IA souveraine repose sur quatre piliers indissociables :

  1. Souveraineté des données : localisation, classification, chiffrement, politiques de rétention, conditions d’accès et de transfert.
  2. Souveraineté du modèle : liberté de choix, portabilité, réversibilité, capacité multi-modèles, gouvernance des versions.
  3. Souveraineté opérationnelle : logs et traces, IAM, SLO, runbooks, supervision et capacité de rollback.
  4. Souveraineté juridique & conformité : exigences RGPD, cadre contractuel de sous-traitance et capacité à démontrer la conformité y compris sur les dimensions de documentation et de record-keeping attendues par l’AI Act lorsque applicable.

En France, la qualification SecNumCloud sert souvent de repère “cloud de confiance” pour les environnements sensibles.

-> A lire sur ce sujet : Règlement (UE) 2024/1689 du Parlement européen et du Conseil du 13 juin 2024 établissant des règles harmonisées concernant l’intelligence artificielle. https://eur-lex.europa.eu/legal-content/FR/TXT/HTML/?uri=OJ:L_202401689 et Posture générale et actions de l’ANSSI sur le cloud, SecNumCloud.

Architecture cible, les 7 briques d’un RAG souverain industrialisable

Nos architectes Data & IA recommandent une architecture structurée autour de 7 briques intégrées dans un cadre d’hébergement et d’exploitation de confiance :

  1. Compute & Hosting : Hébergement dans un environnement maîtrisé (cloud qualifié SecNumCloud, on-premise ou hybride) afin de réduire la surface d’exposition et de garantir la résidence des données.
  2. Model Layer : Accès à des LLM privés ou opérés dans un cadre souverain, avec capacité multi-modèles pour arbitrer performance, coût, latence et contraintes de conformité.
  3. Knowledge Layer : Maîtrise de l’index et du vector store (hybrid search, rerank), avec gouvernance de la fraîcheur (réindexation / re-embedding) et des sources.
  4. Orchestration : Pipelines RAG incluant guardrails, routage intelligent et quality gates (évaluations) pour valider groundedness, conformité et actions autorisées avant restitution.
  5. Security & IAM : Politiques RBAC/ABAC, gestion des secrets, segmentation réseau et policy-as-code pour tracer et contrôler les accès comme les usages.
  6. Observabilité & LLMOps : Monitoring continu (traces, latence, erreurs, groundedness, dérive), journalisation maîtrisée des prompts (masquage PII, rétention), et mécanismes de rollback pour prévenir drift et régressions. (Pour approfondir : Industrialisation RAG, piloter l’IA en production )
  7. FinOps IA & TCO : Pilotage du coût global (tokens, rerank, réindexation, stockage, observabilité, run) pour éviter les surprises budgétaires et tenir un TCO RAG réaliste. (À lire : Combien coûte un agent IA ? Architecture, stack technique et TCO réel pour les DSI.)

La finalité est de rendre la plateforme IA auditable (logs), réversible (modèle & stack) et opérable (SLO + runbooks).

“La souveraineté n’impose pas un mono-fournisseur local : elle requiert la capacité d’arbitrer, d’auditer et de sortir.” Luc Doladille, Directeur Conseil Data & IA, Smartpoint

Grille de critères pour évaluer une plateforme IA / RAG en termes de souveraineté

Une plateforme IA souveraine, c’est la capacité vérifiable à maîtriser vos données, vos modèles, vos accès, vos coûts… et votre sortie.

Mode d’emploi
Note chaque critère : 0 = absent, 1 = partiel, 2 = maîtrisé.
Score max : 30 points.

DomaineCritère012
Données & fluxRésidence des données documentée (régions/pays/sous-traitants, y compris sauvegardes & logs)☐☐☐
Données & fluxClassification appliquée (sensibilité, règles de traitement, data lineage minimal)☐☐☐
Données & fluxRétention & effacement couvrant aussi les données dérivées (embeddings, caches, journaux)☐☐☐
Clés, chiffrement, secretsContrôle des clés (BYOK/HYOK selon besoin), rotation, accès “break-glass” auditables☐☐☐
Clés, chiffrement, secretsGestion des secrets centralisée (vault), séparation dev/test/prod, moindre privilège☐☐☐
Clés, chiffrement, secretsIsolation réseau (segmentation, egress control, politiques as-code)☐☐☐
Auditabilité & traçabilitéTraçabilité bout en bout (requête → retrieval → rerank → réponse → action)☐☐☐
Auditabilité & traçabilitéLogs inaltérables / contrôle d’intégrité (append-only/WORM), horodatage, corrélation☐☐☐
Auditabilité & traçabilitéPreuves d’audit exportables (qui/quoi/quand, rôles, sources, versions modèle/index, décisions de garde-fous)☐☐☐
Knowledge layerGouvernance des sources (liste autorisée, propriétaires, qualité, règles de mise à jour)☐☐☐
Knowledge layerFraîcheur maîtrisée (réindexation/re-embedding, versioning index, suivi de dérive)☐☐☐
Knowledge layerProtection contre attaques RAG (prompt injection, data poisoning, règles de citation/exclusion)☐☐☐
Exploitation & qualitéÉvaluation continue avec protocole (jeux de tests, métriques, seuils, fréquence, owners)☐☐☐
Exploitation & qualitéRollback opérationnel (modèle/prompts/règles/reranker/index) + change management☐☐☐
Exploitation & qualitéPlan de réversibilité contractuel & technique (export vector store/embeddings, orchestration, logs ; clauses de sortie)☐☐☐


Vous avez un RAG qui fonctionne en POC, et vous voulez vérifier qu’il est gouvernable, auditable et maîtrisé en coûts avant la mise en production ? Contactez-nous.

Architecture Data IA, modernisation plateforme data, gouvernance des données, analytics avancés ou renfort projet : que vous cherchiez un partenaire conseil ou des experts opérationnels,
Smartpoint vous accompagne, en mission comme en expertise.

Les champs obligatoires sont indiqués avec *.

Toutes vos questions plateforme IA, RAG et souveraineté

Qu’est-ce qu’une plateforme IA souveraine ?

Une plateforme IA souveraine est un environnement technologique garantissant la maîtrise totale du cycle de vie des données et des modèles, sans dépendance extra-territoriale. Chez Smartpoint, nous définissons cette souveraineté par quatre piliers : la localisation physique des données, l’utilisation de modèles (souvent Open Weights), une infrastructure d’hébergement sécurisée (type Cloud de confiance) et un contrat d’exploitation auditable. Elle permet à la DSI de s’affranchir du vendor lock-in tout en assurant une conformité stricte avec les régulations européennes.

Quelle différence entre RAG souverain et RAG « standard » ?

La différence fondamentale réside dans le contrôle de la chaîne de confiance et l’étanchéité des données. Un RAG « standard » s’appuie généralement sur des solutions SaaS propriétaires (« boîte noire ») où les documents de l’entreprise transitent par des API tierces. À l’inverse, un RAG souverain opéré par intègre le stockage vectoriel et l’inférence du LLM dans un cadre d’hébergement maîtrisé, garantissant que le patrimoine documentaire ne sort jamais du périmètre de sécurité de l’organisation.

SecNumCloud est-il obligatoire pour une IA souveraine ?

Bien que SecNumCloud constitue le plus haut standard de confiance en France, la souveraineté IA repose avant tout sur la capacité à auditer le contrat d’exploitation : qui possède les clés de chiffrement et sous quelle juridiction tombent les données. Pour un projet en production, le choix dépend du niveau de sensibilité des données mais l’utilisation d’une infrastructure qualifiée ou d’un Cloud de confiance est fortement préconisée chez Smartpoint pour neutraliser les risques liés aux lois extraterritoriales.

Comment prouver la traçabilité des réponses d’un RAG ?

La traçabilité s’obtient par la mise en place d’un système d’auditabilité et de tenue de logs rigoureux. Cela implique de documenter chaque étape, de la source documentaire récupérée dans la base vectorielle jusqu’au prompt final soumis au modèle. Cette transparence est essentielle pour répondre aux futures obligations de l’AI Act en matière de documentation technique et de gestion des risques liés aux sorties de l’IA générative.

Comment maîtriser le coût tokens d’un RAG en production ?

La maîtrise du TCO d’un RAG passe par le pilotage précis des coûts d’inférence, de réindexation et d’observabilité. Chez Smartpoint, nous recommandons l’optimisation de la taille des chunks et l’utilisation de modèles adaptés à la tâche (plus légers que les modèles généralistes) pour réduire la consommation de tokens. Une approche souveraine permet souvent une meilleure prédictibilité budgétaire en évitant les fluctuations de prix des API propriétaires.

Quelle gouvernance de l’IA pour être conforme AI Act et RGPD ?

Une gouvernance solide doit garantir que le système est exploitable, auditable et totalement sous contrôle de la DSI. Cela nécessite un cadre d’exploitation maîtrisé incluant des exigences de sécurité strictes et une traçabilité des données d’entraînement et d’inférence. Ce socle de confiance permet de transformer l’IA en un copilote privé fiable, répondant aux impératifs de protection des données personnelles (RGPD) et aux critères de transparence de l’AI Act.